今日開催された ISUCON 2026 に参加して、負けました。
11月3日追記: 競技環境が11月23日まで開いていたので、感想戦として全オンメモリ構成を作り直し、ポータル上の自己最高 544,004 点まで伸ばしました。記事の最後の「感想戦」の節に追記しています。
競技終了26分前の 17:34、それまで2時間かけて作っていた約2,100行のオンメモリ状態管理(StateStore)が再起動試験の整合性チェックで落ち、本番ブランチから Revert しました。Revert 後にログとコードから原因候補を調べて修正を書きましたが、再びマージして再起動試験を通し切る時間は残っていませんでした。
記憶が新しいうちに、今日やったことと、なぜ最後のオンメモリ化で整合性を落としたのかを書いておきます。
題材とマシンの癖
今回の題材「ISUREAL」は、BeReal のような写真共有アプリです。地域ごとに開く投稿ウィンドウ(posting_windows)に合わせて写真を投稿し、友達の投稿に写真リアクション(RealMoji)やコメントを付け、フィードや過去の振り返り(Memories)を見ます。
与えられたサーバはルータを除くと4台です。アプリサーバが3リージョン(asia1・europe1・america1)に1台ずつあり、データベース(PostgreSQL 16)は asia2 の1台だけで動いています。
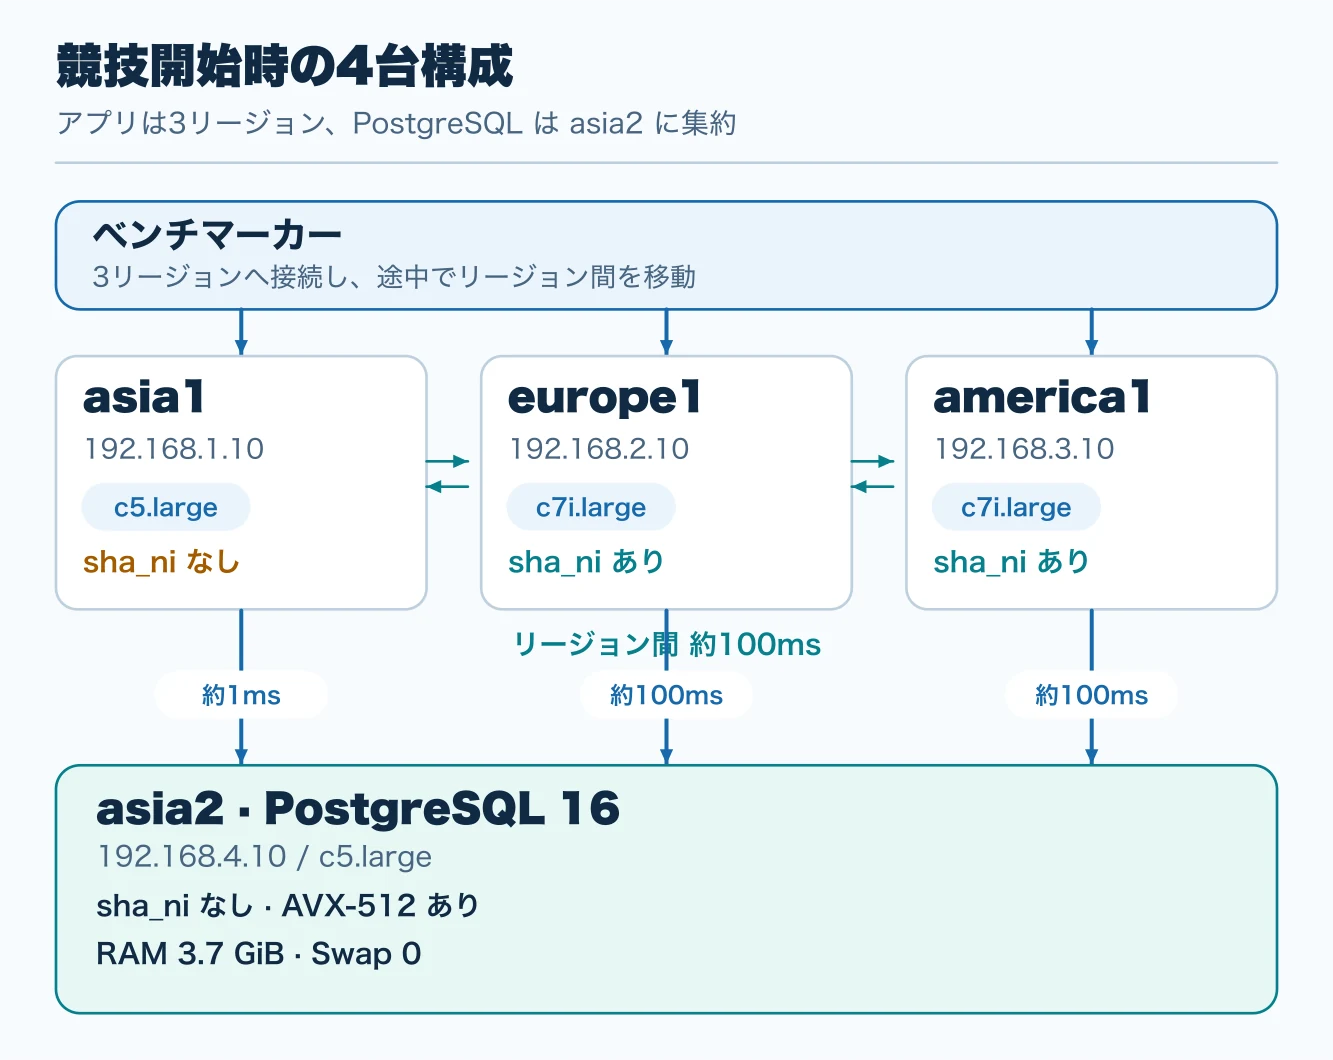
設計を決めるうえで効いてくる制約は3つありました。
- 大陸間の往復 100ms の距離: DB のある
asia2へは、asia1からは約1msで引けますが、europe1とamerica1からは1クエリごとに往復約100msかかります。初期実装のように1リクエストの中で5〜6回 SQL を直列に投げると、通信待ちだけで500〜600ms消えます。トランザクション内でロックを取ったあとの通信待ちは、そのまま他のリクエストがロックを待つ時間にもなります。 - CPU の
sha_niの有無と 1,000 回連鎖の HMAC-SHA256 署名: このアプリは、フィードや Memories で返すほぼすべての画像 URL(/api/images/:id?exp=...&sig=...)にオーナーごとの鍵で署名を付けます。しかも HMAC-SHA256 を1回計算するのではなく、前の出力を次の入力にして 1,000 回連鎖させる仕様です。/proc/cpuinfoを見ると、europe1とamerica1(Sapphire Rapids /c7i.large)には SHA-256 のハードウェア命令(sha_ni)がありますが、asia1とasia2(Cascade Lake /c5.large)にはありません。asia1ではこの署名計算だけで CPU の約4割が消えていました。 - RAM 3.7 GiB / Swap 0: 4台ともメモリは 3.7 GiB でスワップがありません。とくに PostgreSQL が動く
asia2は、初期データだけで約9GBの画像テーブル(image_objects)を抱えており、コネクション数やバッファを増やしすぎるとすぐに OOM killer が動きます。
スコアの推移と2つの作業ライン
序盤から myuon さんがベンチマークごとの時刻とスコアを記録してくれていました。10:08 の初回は 2,650 点、16:05 の PgBouncer 導入時点で 125,720 点です。ずっと右肩上がりだったわけではなく、1回ごとのスコアのブレに悩まされながら、退行したら戻して進めています。
| 計測時刻 | スコア | その時点で入れていた主な変更 | fail |
|---|---|---|---|
| 10:08 | 2,650 | 初期状態 | 4 |
| 10:30 | 19,405 | インデックス追加、署名キャッシュ、DB接続再利用 | 0 |
| 11:23 | 26,837 | 書き込みトランザクションのPL/pgSQL関数化、通知インデックス | 0 |
| 11:47 | 35,693 | JPEGヘッダ検査の軽量化、画像DB書き込みの非同期化 | 0 |
| 12:14 | 47,277 | ユーザー検索のオンメモリ化とロック範囲の縮小 | 20 |
| 13:10 | 66,466 | ピア通信(:8081)で海外へ署名委譲、画像配布、フィードSQL絞り込み | 0 |
| 13:42 | 73,414 | 通知取得の1クエリ化、フィードの閲覧判定改善 | 0 |
| 14:35 | 85,133 | SSE通知のメモリ配信、新規画像のnginx X-Accel-Redirect | 0 |
| 14:54 | 87,199 | Go 1.27のAVX-512(16レーン並列)署名を有効化 | 0 |
| 15:26 | 96,424 | DB接続プール縮小(OOM回避)、ログインセッションのオンメモリ化 | 0 |
| 15:55 | 110,614 | shared_buffers を768MBに縮小、Memoriesの2クエリ並列化 | 0 |
| 16:05 | 125,720 | PgBouncer導入(アプリ側プール上限700、DB実接続90) | 0 |
15時過ぎからは、作業が2つのラインに分かれました。
- myuon さんのライン(
mainブランチ): PostgreSQL を正(Source of Truth)としたまま、16時以降もクエリの1往復化、再起動時の DB プリウォーム、asia2への署名専任プロセスの分離などを1つずつ積み上げて検証するライン。 - 私のライン(別ブランチの
StateStore): 残る全テーブルを各アプリサーバのメモリに載せ、書き込み差分だけをピア間で配信して、海外リージョンからの DB 読み取り自体をゼロにしようとしたライン。
まず、main ブランチ側でスコアを伸ばした4つの仕組みをまとめます。
main ブランチで効いた4つの仕組み
1. 100ms の DB 往復を削る(PL/pgSQL 関数化とクエリ統合)
初期実装の書き込み処理(投稿作成や友達承認など)は、Go 側でトランザクションを開いてから「存在確認 → 権限チェック → INSERT → 通知の登録 → COMMIT」と5〜6回 SQL を直列に投げていました。europe1 や america1 からこれを行うと、DB の行ロックを握ったまま 100ms × 5〜6回 = 500ms 以上も大陸間の通信を待つことになります。
そこで主要な書き込み処理をすべて PostgreSQL の PL/pgSQL 関数にまとめ、Go からは SELECT func(...) を1回呼ぶだけ(1往復・100ms)で完結するように書き換えました。これでロックを握ったまま大陸間通信を待つ時間がなくなりました。
読み取り系でも、複数回に分かれていたクエリを1往復にまとめています。
- 通知一覧・投稿詳細・プロフィール取得: 閲覧権限のチェックとデータ本体の取得を並列化または1クエリに統合し、2〜3往復かかっていた処理を1往復に短縮。
- 友達の友達(
fof)フィード: 候補ユーザーの絞り込みからスコア計算まで最大6往復かかっていた処理を1本の SQL に集約(本番 DB の400人全員で旧実装と結果・順序が一致することを確認して投入)。 - 部分的なオンメモリ化: 全テーブルではなく、他テーブルと複雑に絡まない「ユーザー検索一覧」「ログインセッション」「SSE の通知配信」だけを先にオンメモリ化。
2. 内部ピア通信(:8081)による画像の直接配布(Push + オンデマンド Pull)
pg_stat_statements を見ると、DB 時間の1位(1回のベンチマーク走行あたり合計132秒)は image_objects テーブルへの画像データ(bytea)の読み書きでした。
初期データとして PostgreSQL に入っていた約9GBの画像は、あらかじめ各アプリサーバのローカルディスク(/home/isucon/image-cache/<id>)へ書き出しておき、DB を引かずに nginx の X-Accel-Redirect で直接配信するようにしました。
問題はベンチマーク中にアップロードされる新規画像です。各アプリサーバにプライベート IP 限定の内部 HTTP ポート(:8081)を開き、DB の image_objects テーブルには署名検証用のメタデータ(所有者 ID と作成時刻)だけを空の data = '' で入れ、画像本体(JPEG バイト列)はアップロードを受けたサーバから他リージョンのピアへ直接配る仕組みにしました。
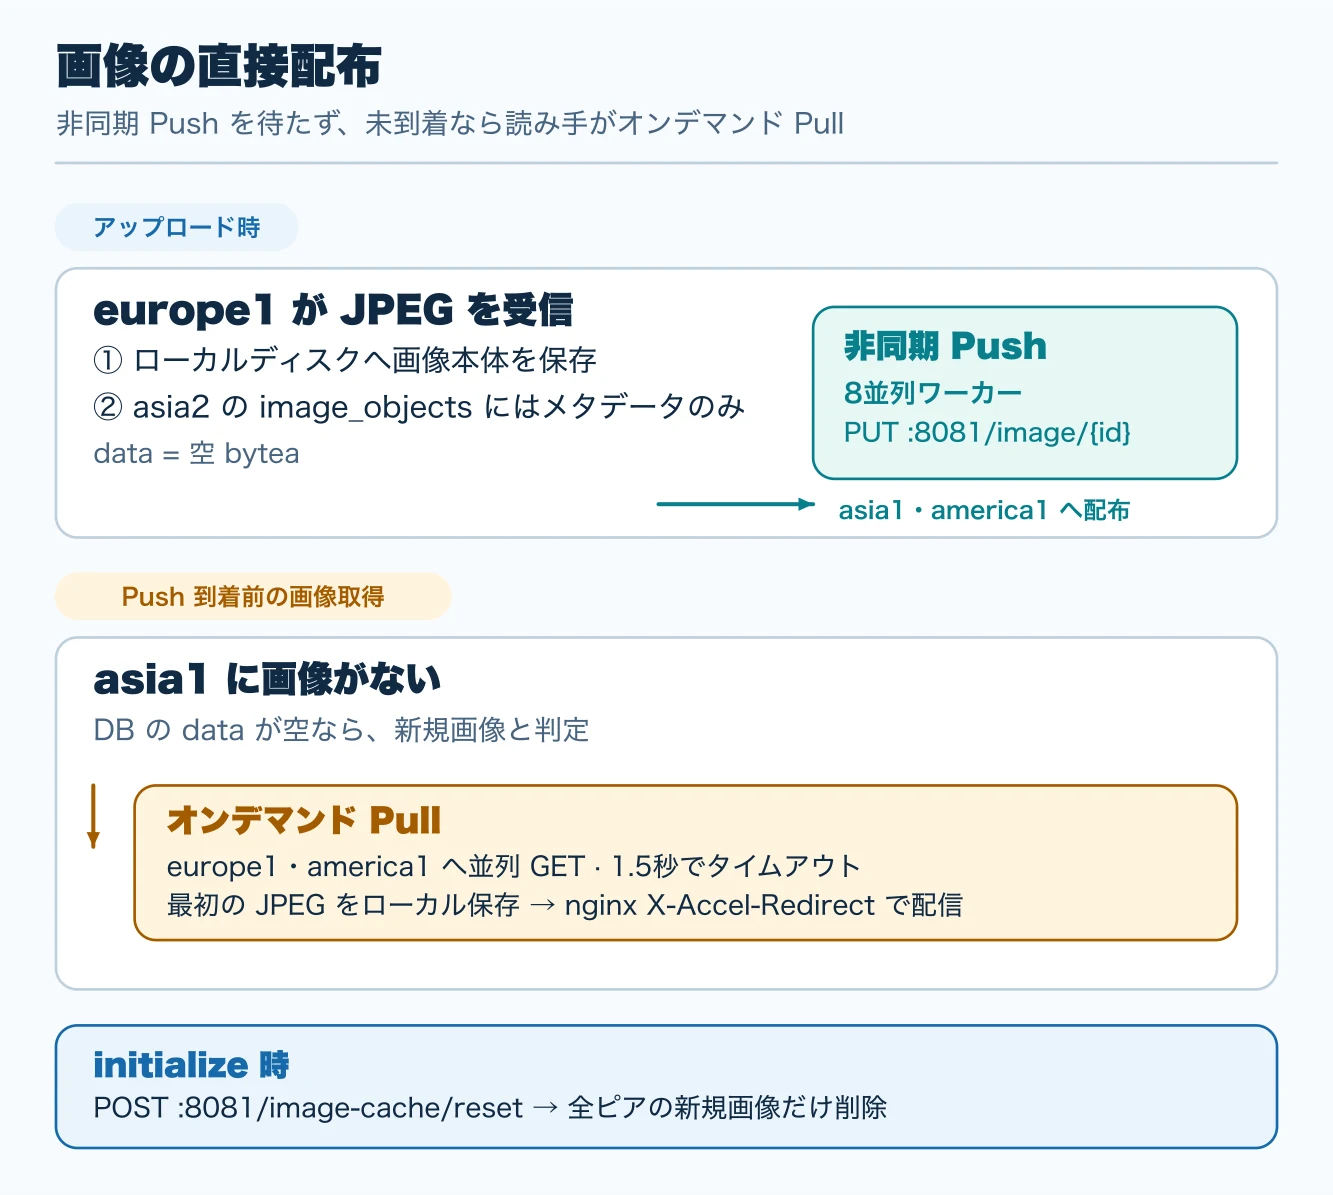
この仕組みが最後まで安定して動いた理由は、非同期 Push(PUT /image/{id})だけでなく、ローカルに無かったときのオンデマンド Pull(GET /image/{id})を持っていたからです。ヨーロッパでアップロードされた直後の画像が、100ms の非同期 Push が届く前にアジアでリクエストされても、アジアのサーバがその場で他ピアへ取りに行けるため、整合性を落とさずに DB への画像書き込みをゼロにできました。
3. 1,000回連鎖の HMAC-SHA256 署名を速くする(AVX-512 16レーン並列と署名専任プロセス)
画像 URL 1つあたり HMAC-SHA256 を 1,000 回連鎖させる処理には、4段階で手当てを入れました。
- 有効期限(
exp)の60秒丸めとオンメモリキャッシュ: 毎回異なる秒数で署名するのをやめ、expを60秒単位のバケットに丸めて計算結果をメモリにキャッシュしました(一度1時間単位に広げましたが、ベンチマーカーの有効期限チェックで弾かれたため60秒に戻しています)。また、現在のバケットの残り時間が20秒を切ったら次の+60秒バケットの署名を裏で先回り計算するようにしました。 - 海外リージョン(
sha_niあり)への署名委譲: 昼の時点では、sha_niのないasia1から、内部ポート:8081に作ったPOST /signを使ってeurope1・america1(sha_niあり)へ未キャッシュの署名バッチを投げて計算させていました。 - Go 1.27 の
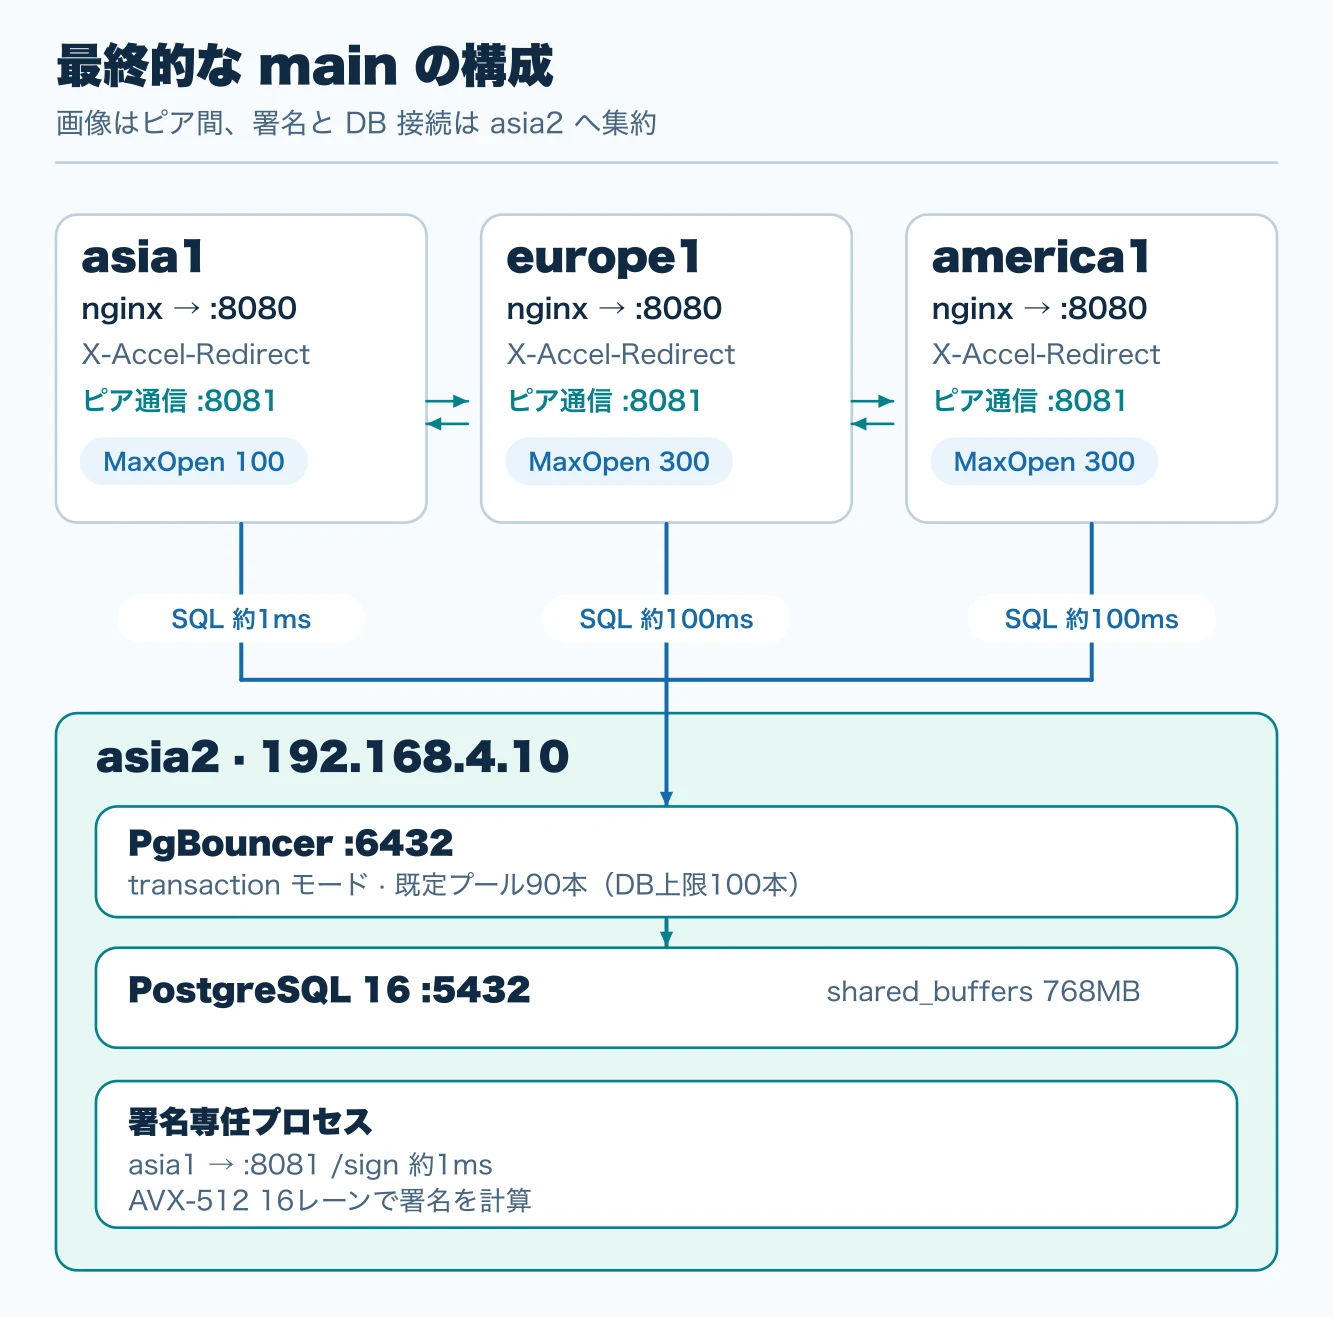
GOEXPERIMENT=simdによる AVX-512 16レーン並列計算:asia1とasia2にはsha_niはありませんが、512ビット幅の AVX-512 は使えます。1つの画像 URL の署名は「前回の出力を次の入力にする」直列1,000回の計算なので1本だけでは SIMD になりませんが、フィードや Memories では1リクエストで数十枚の画像 URL にまとめて署名を付けます。そこで独立した16本の署名を束ね、512ビットレジスタ(archsimd.Uint32x16)の16レーンに1本ずつ割り当てて、連鎖計算を16本同時に回すようにしました。 asia2に署名専任プロセス(:8081)を置く: 終盤(17:24)、asia1から頼まれた署名計算でeurope1とamerica1の CPU が約25%使われ、ピーク時に海外2台の CPU が詰まっていることが分かりました。すでに AVX-512 の16レーン並列署名は動いていたため、CPU に余裕のあった DB サーバasia2に署名専用のアプリプロセス(:8081、nginx の振り分け対象外)を立て、asia1からは往復1msのasia2:8081へ署名を委譲するように切り替えました。
4. RAM 3.7 GiB / Swap 0 での OOM 回避と PgBouncer
europe1 と america1 は DB クエリ1回ごとに往復100msの間コネクションを掴み続けるため、アプリの接続プールが小さいとすぐにコネクション待ちになります。しかし、PostgreSQL の max_connections を 400 に上げて3台のアプリから合計310本つないだところ、asia2(RAM 3.7 GiB / Swap 0)のメモリが尽きて PostgreSQL が OOM killer に落とされました。
そこで PostgreSQL の shared_buffers を 1.5GB から 768MB に下げたうえで、asia2 に PgBouncer(transaction モード) を入れました。
- アプリ側の接続プール上限:
europe1300 +america1300 +asia1100 = 合計 700 本 - PgBouncer から PostgreSQL への実接続:90 本(上限 100 本)
これで「大陸間の100ms待ちでコネクションが詰まる問題」と「PostgreSQL のバックエンドプロセス増大による OOM」を同時に解消できました。さらに 17:05 には、再起動試験の直後に DB キャッシュが空で initialize が 504 になったのを受け、asia2 の起動時に全テーブルを先読みする systemd サービスも追加しています。
ここまでの main ブランチの最終形を図にすると次のようになります。
なぜ最後の全テーブルオンメモリ化(StateStore)で落ちたのか
上記の main ブランチの延長線上だけでもスコアは伸びていましたが、私は15時過ぎから別ブランチで、残る全テーブル(ユーザー・投稿・コメント・RealMoji・フォロー・ブロック・友達申請・通知・閲覧履歴)をすべてメモリに載せる StateStore(約2,100行)を自分のエージェントに実装させていました。europe1 や america1 から asia2 へ行く1往復(100ms)すらゼロにして、すべての読み取りを各リージョンのローカルメモリだけで返そうという狙いです。
仕組みとしては、内部ポート :8081 に POST /state/op と POST /state/reload を追加し、書き込みを受けたサーバが PostgreSQL を更新したあと、他の2リージョンのピアへ変更差分(StateOp JSON)をブロードキャストしてメモリを更新する設計でした。
16:55 に一度 main にマージして17:11 に戻し、修正を入れて 17:30 に再び main へマージしました。単発のベンチマークでは動いていたのですが、終了26分前の 17:34 の再起動試験で整合性チェックに落ちました。投稿したはずのコメントが無い、GET /api/notifications が 401 になる、友達の友達フィードのスコアが 1〜2 ズレる、差し替えたはずの RealMoji が古いまま返る、画像が 403 image_forbidden になる、といったエラーが一斉に出たため、その場で Revert しました。
Revert 後の残り時間と競技後にログとコードを調べて見つけた原因候補は以下の3つです。再びマージして本番の再起動試験を通す時間はなかったため本番環境での解消までは未検証ですが、コードに入っていた欠陥自体ははっきりしています。
1. リージョンをまたぐユーザー(user moved)と Push のみの非同期キュー
ログを追って分かったのが、ベンチマーカーのユーザーが途中で接続先リージョンを移動する(user moved)ことでした。
画像のピア配布では「非同期 Push が間に合わなくても、読まれたサーバが他ピアへ GET /image/{id} で取りに行く(オンデマンド Pull)」という逃げ道がありました。しかし StateStore は、投稿もコメントもセッションもローカルメモリにあるものだけを即座に返す Push のみの設計でした。
しかも当初の実装では、他リージョンへの POST /state/op(往復100ms)で書き込みレスポンスが遅くなるのを嫌い、ピアへの送信が 800ms でタイムアウトしたらピアごとの非同期リトライキュー(peerRetryQueue)に積んで、クライアントにはすぐ HTTP 200/201 を返していました。
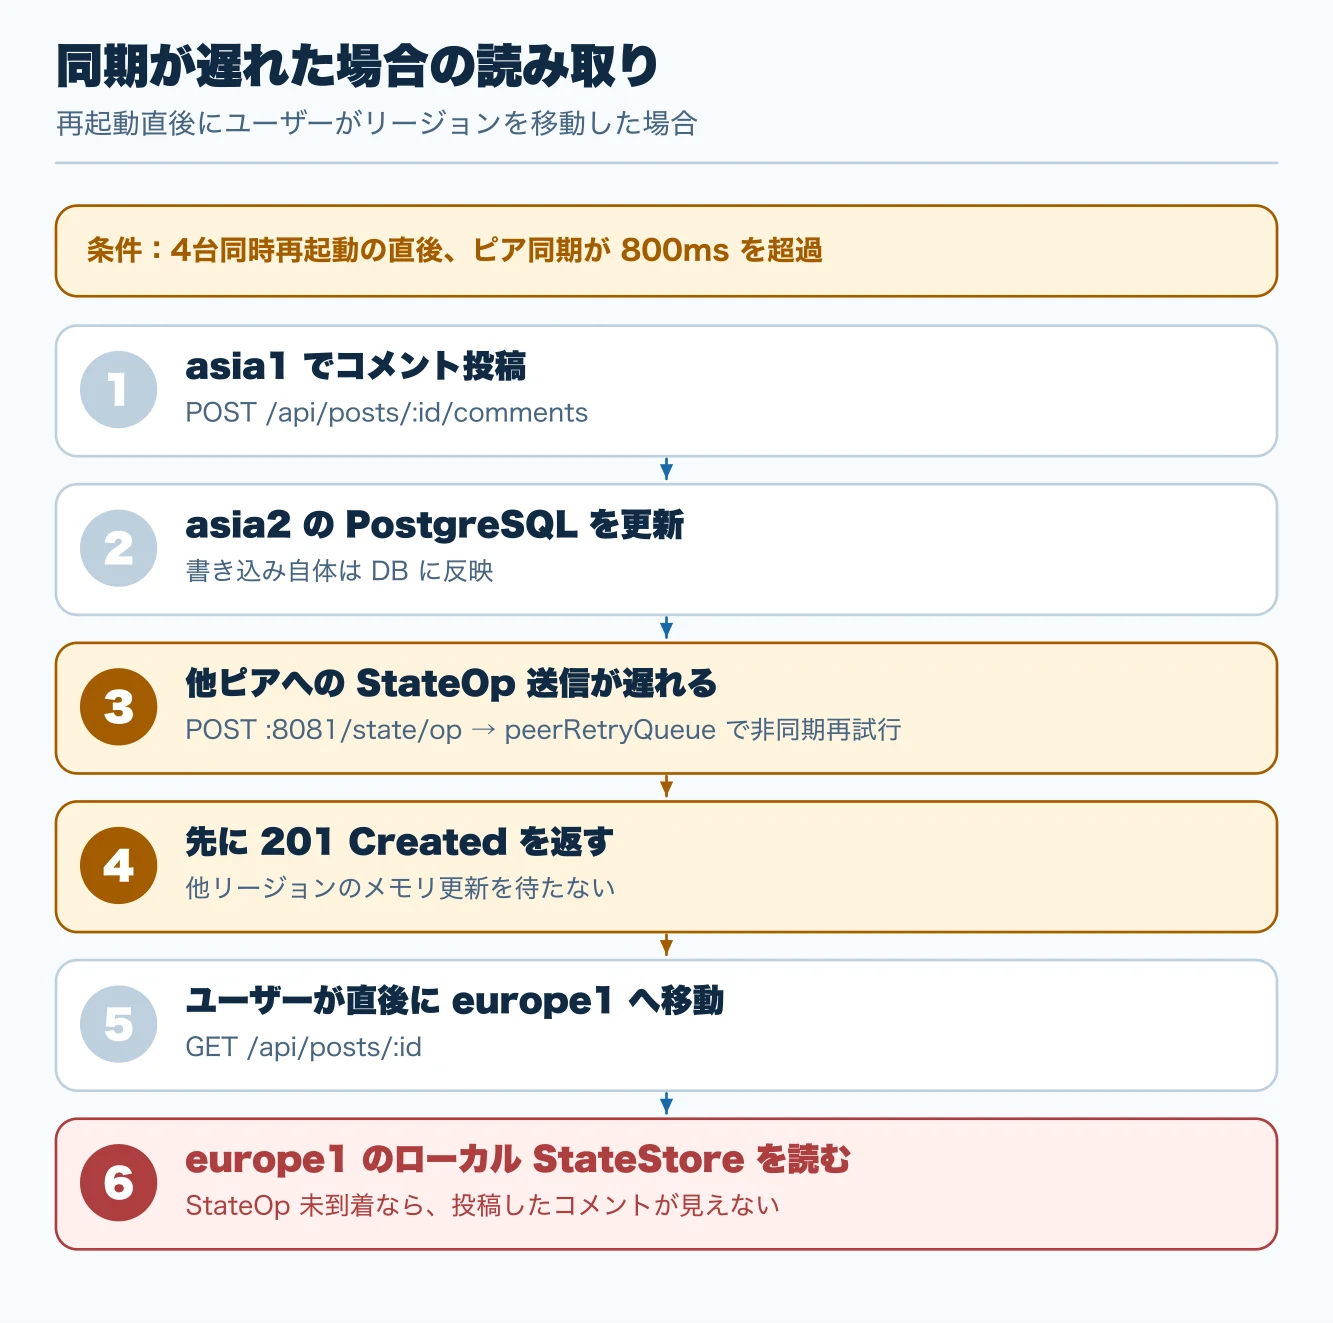
4台同時再起動の直後は DB の接続もキャッシュも冷えており、ピア間の HTTP 接続も張り直しになるため同期が遅れます。その状態で、asia1 でコメントや友達承認やログインをしたユーザーが直後に europe1 に移動して読み取りを行うと、まだ europe1 のメモリに StateOp が届く前に自分の書き込み結果を読みに来てしまいます。Revert 後の 17:46 に入れた修正では、書き込み後に最大3秒までピアへの同期完了を待つように変えました。
2. アプリの時計と DB の時計の混在
各サーバに届く StateOp の順序逆転を防ぐため、データの更新時刻を比べて新しい方だけを採用する Last-Write-Wins(LWW)を入れていましたが、ここに時計の混在がありました。
大半のテーブルでは DB 側でロックを取った時点の clock_timestamp() を使っていましたが、RealMoji の差し替え関数だけ、引数で渡したアプリサーバの時刻(p_created_at)をそのまま新しい行の created_at に入れていました。
-- 修正前: 旧行を replaced_at で無効化したあと、アプリ時計由来の値で新しい行を作る
INSERT INTO realmojis (id, post_id, reactor_id, image_id, reaction_type, created_at)
VALUES (p_realmoji_id, p_post_id, p_actor_id, p_image_id, p_reaction_type, p_created_at);
リージョンを移動したユーザーが、時計のわずかに遅れた別サーバで RealMoji を差し替えると、新しい RealMoji の created_at が古い方より小さくなり、StateStore 側で「古いイベントが遅れて届いた」と判定されて捨てられる経路がありました。
3. initialize で戻らない初期画像の削除とメタデータの欠落
終了間際に見つけたのが、画像キャッシュ周りの2つの不整合です。
1つ目は、初期データのプロフィール画像削除バグです。POST /api/initialize で走る reset.sql は、初期ユーザーの profile_image_id を initial_users から復元しますが、image_objects テーブルの初期データ行やディスク上の /home/isucon/image-cache/<id> は復元しません。初期データの画像は消えない前提になっているためです。
ところが、初期データに含まれるユーザーがベンチマーク中にプロフィール画像を更新・削除すると、私たちのコードは古い画像 ID に対して DELETE FROM image_objects WHERE id = $1 と os.Remove(imageCachePath(id)) を呼んでいました。1回目のベンチマークで初期ユーザーがプロフィール画像を変えると、次のベンチマークの initialize で profile_image_id だけが初期値に戻り、実体の画像が DB にもディスクにも無くなって 403 になり得ます。
// 修正後: 初期データ境界より後の画像だけを DB から消し、ディスクの初期画像ファイルは残す
_, _ = item.db.ExecContext(ctx, `
    DELETE FROM image_objects
    WHERE id = $1
      AND created_at > COALESCE((SELECT created_at FROM initial_data_boundary LIMIT 1), '-infinity'::timestamptz)
`, item.imageID)
2つ目は、ピアから受け取った新規画像のメタデータをディスクに保存する際、所有者 ID だけを書いて作成時刻(created_at)を保存し忘れていたことです。再起動後にディスクから読み戻すと作成時刻が time.Now() に置き換わってしまい、作成時刻を条件に含む DB フォールバック検索が外れて 403 image_forbidden になり得る実装になっていました。
反省
振り返ると、勝負をかけるべきだったのは、画像以外をすべてインメモリにする構成だったと思います。画像を除けばデータ全体がメモリに収まることは確認できていました。大陸間の DB 往復を1回ずつ減らす改善と並行して、その往復自体をなくす実装を、もっと早く進めるべきでした。
午前中は1人で Claude Code をぶん回す形で進め、2万点を超えたあたりで Opus 5.5 が詰まり始めてから、並列で Argon を回し始めました。もしやり直すなら、開始直後から Opus 5.5 に画像以外の全体をインメモリにする実装を任せ、別の AI でインデックスや SQL、署名計算、画像配布といった着実な改善を回しておきたかったです。動く構成でスコアを積み上げながら、大きく伸ばすための別系統も育てる。その2つを最初から並行して進めるのが重要だったのだと思います。
実際に Argon が全体のインメモリ化を実装し始めたのは15時過ぎでした。そこから競技終了までの約3時間では、実装だけでなく、統合、本番ベンチマーク、再起動後の整合性確認まで終えられませんでした。Delve なども使ってデバッグしていましたが、通常のベンチが通ったあとも、リージョンを移動した直後の読み取りや、再起動・初期化をまたぐ状態の復元に問題が残りました。
ベンチマークの待ち時間も大きかったです。エージェントがコードを書く速度に対して、本番ベンチマーカーが回り切るまでに時間がかかり、点数のブレもあるため、修正して確認するたびに残り時間が減っていきました。序盤から、書き込み直後に別リージョンで読む、同期を遅らせる、再起動して読み直す、といった短い再現試験を用意しておけば、本番ベンチを待つ間にも不具合を潰せたと思います。
今回の敗因として大きかったのは、全体をインメモリにしようとしたことよりも、その実装に着手するのが遅く、動かして壊して直す時間を十分に残せなかったことだと思います。開始直後から Opus 5.5 に任せていれば成功した、とまでは言えません。ただ、勝負になる構成を早く作り、着実な改善を続ける別系統と比較しながら、検証とデバッグを何度も回せる時間を確保したかったです。
感想戦(11月3日):全オンメモリで 544,004 点
競技環境は11月23日まで残っていたので、11月3日に感想戦をしました。当日に落とした「画像以外を全部メモリに載せる」構成を、Claude Code(Opus 5.5)に一から作り直してもらう形です。私がやったのは、ベンチマークを回して結果を貼ることだけでした。設計、実装、配備、計測、ログの分析はすべてエージェントに任せています。
結果は、ポータル上の自己最高が 544,004 点 でした。16時55分の時点のリーダーボード(最新スコア順)では2位です。1位の Anago は最高 594,503 点、優勝した Typing Bears は最高 629,638 点なので、上位とはまだ差があります。
先に結論を3つ書いておきます。
- 整合性は、書き込みに全順序を付けたら解決した。当日と同じ「各サーバが配り合う」方式は感想戦でも落ち、シーケンサー方式に替えてからは整合性違反がほぼ出なくなりました。
- 50万点を超えてからは、サーバではなくベンチマーカーの処理能力が壁だった。サーバを速くするより、倍率1倍の asia を抑えて、1.5倍の europe と america に能力を使わせるほうが効きました。
- 同じ構成でも約10%ばらつく。利用者の増え方が掛け算で効くためで、1回の走行で良し悪しは判断できません。
11月3日のスコアの推移
| 時刻 | スコア | その時点で入れた主な変更 |
|---|---|---|
| 06:46 | 0 | 全オンメモリ版の初回。nginx の worker_connections 不足で EOF と 502 |
| 07:22〜08:10 | FAIL ×5 | 各サーバが書き込みを直接配り合う方式で、整合性違反(見えてはいけない投稿、古い友達一覧) |
| 08:38 | — | asia2 に書き込みの順番を決めるシーケンサーを置く方式に切り替え |
| 09:02〜09:20 | FAIL ×3 | PostgreSQL の接続数上限、ログインの非同期化で地域外アクセスが 403 にならない |
| 10:45 | 276,068 | 初めて完走 |
| 11:10 | 300,956 | asia の Memories とエクスポートを asia2 の読み取り専用プロセスへ |
| 11:47 | 325,436 | 署名付きセッショントークン |
| 12:45 | 366,054 | 初期データの過去投稿を読み取り専用ファイルから引く |
| 13:17 | 420,044 | 書き込み記録の非同期化、JPEG はヘッダだけ検査 |
| 13:29 | FAIL | 読み取り専用プロセスが追いつけず、古い状態でフィードを返した |
| 15:22 | 504,018 | フィードの索引、asia1 の署名検証を europe と america へ |
| 15:31 | 467,519 | グランプリの通知のずらしを外す実験(失敗、戻す) |
| 15:37 | 517,618 | asia の投稿の応答を、投稿期間あたり54件を超えたら2秒遅らせる |
| 15:56 | 527,012 | エクスポートの画像を並列に先読み |
| 16:48 | 529,972 | 合計リクエストが多いときだけ asia の Memories を最大300ms遅らせる |
ポータルの最高 544,004 点は、結果を貼り忘れた走行のどれかで、どの変更の回だったかは追えていません。
当日と何が違ったのか:書き込みに全順序を付けた
当日の StateStore は、書き込みを受けたサーバが他のサーバへ差分を直接配り、更新時刻の新しい方を採る(Last-Write-Wins)方式でした。感想戦でも、朝の5回はこの方式で整合性違反を出しています。公開範囲の変更が投稿の作成より先に届いて捨てられる、届く順番が逆転する、といった失敗です。
そこで、優勝した Typing Bears の参加記と同じ設計に切り替えました。
asia2にシーケンサーを1つ置き、すべての書き込みに通し番号を付ける。各サーバは、シーケンサーから流れてくる同じ順番の列をそのまま当てる。- 書き込みは、シーケンサーが番号を付けた時刻 T から 60ms(δ)経ってから応答する。
- 読み取りは、手元に当てた列が「いま − 60ms」まで追いつくのを待ってから処理する。5秒待っても追いつかなければ、古い状態は返さず 503 にする。
書き込み:  europe1 ──POST /seq/cmd──▶ asia2(番号 n、時刻 T を付ける)──▶ 全サーバへ同じ順で配信
           europe1 は T+60ms まで待ってから利用者へ応答

読み取り:  asia1 は「手元に当てた列の時刻 ≥ いま − 60ms」になるまで待ってから処理
           → T+60ms より後に始まった読み取りは、番号 n までを必ず含む
これで「どのサーバで書いても、応答したあとの読み取りには必ず反映される」が成り立ちます。δ を 60ms にしているのは、asia2 から europe と america への片道が約50msだからです。
ほかに効いたのは次の5つです。
- DB に書かない。PostgreSQL は
initializeで初期データを読むときにしか使いません。永続化は、シーケンサーが番号順の書き込みを JSON Lines のファイルに足していき、起動時に頭から当て直す方式です。8万4千件を約0.8秒で戻せます。 - 署名を前もって計算する。画像 URL の有効期限を UTC 11時と23時の12時間区切りに固定し、初期データの画像183万枚ぶんの署名を表にしておきました。新しい画像は作るときに1回だけ署名し、その署名を同期の列に載せて全サーバへ配ります。手元で計算するのは、ベンチマーカーが自分で毎秒違う期限で作る URL だけで、これも
asia1では SHA-NI のある europe と america に頼みます。署名の参照の99.5%以上は計算なしで済んでいます。 - ログインを待たない。セッショントークンを全サーバ共通の鍵で HMAC 署名し、同期が届く前でもどのサーバでも本物と確かめられるようにしました。
- 過去の投稿は読み取り専用ファイルから引く。初期データの投稿・RealMoji・コメントを、利用者ごと・月ごとの JSON ブロックに分けて1GBのファイルにしました。最初は利用者単位のブロックで、Memories で1か月分が要るだけでも1人分全部を読んでいて、読み取り専用プロセスの CPU の31%が JSON のデコードでした。
- 不正なアップロードを先頭で断る。プロフィール画像や投稿の画像は、先頭64KBの JPEG ヘッダで不正と分かれば、残りを読まずに 400 を返して接続を閉じます。2位の ichyo さんの参加記に、ルーターの上り通信の約6割がベンチマーカーの送る10〜32MBの不正な画像だったと書かれていたのを読んで入れました。
50万点からの壁は、サーバではなくベンチマーカーだった
50万点を超えたあたりから、サーバを速くしてもスコアが伸びなくなりました。europe1 と america1 の CPU は20〜40%しか使っておらず、サーバ内の処理は1ms未満です。それでも4台合計のリクエスト数は毎秒約1万で頭打ちになります。Typing Bears の参加記にも、同じ観察として「ボトルネックはベンチマーカー側の処理能力」と書かれていました。
ベンチマーカーの処理能力が一定なら、スコアはその能力を何に使わせるかで決まります。配点を見ると、europe と america の得点は1.5倍です。さらに、初期データの利用者が「ログイン → Memories → 画像 → ログアウト → エクスポート」を休まず繰り返す巡回が、スコアの約6割を占めていました(エクスポートは1回20点です)。この「約6割」は Typing Bears の参加記の推定で、私たちの走行ごとの件数に配点を掛けた概算でもほぼ同じでした。そこで、倍率1倍の asia の活動を抑えて、europe と america の巡回に能力を回しました。
| 手 | 結果 |
|---|---|
| asia の投稿の応答を、投稿期間あたり54件を超えたら2秒遅らせる | asia の5日目の利用者が 1,324人 → 359人。ルーターの 503 と EOF が消えた。504,018 → 517,618点 |
| グランプリの通知を europe → america(+2.5秒)→ asia(+5秒)の順にずらす | 外すと asia のグランプリ参加は2倍になったが、europe と america が約100% → 69%に落ちて 467,519点。戻した |
| 合計が毎秒6,000を超えたら、asia の Memories を最大300ms遅らせる | america の Memories の閲覧が 11,511 → 14,910回(+30%)、asia は −25%。asia1 の送信帯域の上限超過が1走行 1,033回 → 107回 |
逆に、asia のエクスポートを速くした変更は、スコアをあまり伸ばしませんでした。読み取り専用プロセスでのエクスポートは 820ms から 30ms になりましたが、そのぶん asia の巡回が速く回り、ベンチマーカーの能力を europe と america から奪っていたからだと見ています。サーバを速くすることと、スコアが上がることが一致しない問題でした。
同じ構成でも 48万〜53万点にばらつく
最後の1時間は、構成を変えずに何度も回しました。それでもスコアは 481,875点から 529,972点まで散らばりました。
一番効いていたのは、利用者の増え方のばらつきです。利用者は1日ごとに約3倍に増えるので、序盤の小さな差が最後まで掛け算で効きます。europe の5日目の利用者は、同じ構成の走行で 263人から 604人まで違いました。2日目の時点で13人だった回と25人だった回の差です。
最終スコアは「最後に回した走行」なので、終盤は目標を決めて、それを超えた回で止める(それより後は回さない)のが合理的でした。
計測でやらかしたこと
- ディスク使用率を過大に出していた。2秒ごとに測るスクリプトで、通信の確認などの時間を含めて実際には約3秒かかっていたのに、2秒で割っていました。100%を超える値で「飽和」と判断していたのは誤りでした。
- 累計の件数を走行ごとに比べていた。
/debug/routesはプロセス起動からの累計なので、再起動を挟まないと複数走行ぶんが混ざります。途中から、走行の開始時と終了時の差分を取るようにしました。 - プロファイルを取り逃した。走行の開始を「起動時からの件数の増分」で判定していたので、アプリを再起動したあとの走行を見逃しました。2秒間の件数の増え方で判定するように直しました。
- テストが通っていても、レビューで3つの欠陥が見つかった。成功を返した書き込みが記録ファイルに書かれる前に再起動すると消え得る、エクスポートの先読みのメモリに上限がない、画像の読み込み失敗を「画像なし」として欠けた ZIP を 200 で返し得る、の3つです。3つ目は、初期データの期待値と一致しないとして走行全体が FAIL になり得るものでした。どれもテストでは作っていない状況(再起動の瞬間、遅いクライアント、一時的な I/O エラー)でした。
時間が無限にあったら、次に直すもの
- ベンチマーカーとルーターを資源として測る。スコアのばらつきが±5%あるので、1つの構成につき5回以上回して平均で比べます。
- ルーターを通る通信を減らす。
tracepathで確かめると、同じ asia のasia1からasia2への通信もルーター(192.168.10.10)を通っていました。読み取り専用プロセスで作ったエクスポート(1回約2MB)は、ルーターを2回通っています。エクスポートをasia1で作るか、利用者ごとに画像を1つのファイルへ並べて読み込みを減らすほうがよさそうです。シーケンサーの配信も圧縮できます。 - 利用者の増え方の規則を調べる。ばらつきの一番大きな原因なので、序盤の失敗や待ち時間と増え方の関係を測りたいです。
- 利用者ごとの書き込みを、その人の地域で順番付けする。europe と america の書き込みは、シーケンサーまでの往復で約110msかかります。ただし、閲覧の上限に対する達成率はどの地域でも同じくらい(フィードで約5割)なので、書き込みの待ち時間ではなくベンチマーカーの間隔で決まっている可能性が高く、先に測ってからにします。
- 細かい残り。画像配信で初期画像の参照を DB に聞いている部分を事前計算に置き換える、通知の購読でまれに出る 401 の競合を直す、などです。
感想戦を終えて
当日の反省に書いた「画像以外を全部メモリに載せる構成で勝負すべきだった」は、方向としては合っていたと思います。当日に足りなかったのは、整合性の取り方(各サーバが配り合って時刻で勝敗を決める方式)と、着手の早さでした。シーケンサーで全順序を付ける方式に替えてからは、整合性違反はほぼ出なくなりました。
もう1つの学びは、50万点を超えてからは「サーバを速くする」より「ベンチマーカーの能力を何に使わせるか」の勝負になっていたことです。ここには、他チームの参加記と、走行ごとの差分の計測がなければ気づけませんでした。