VDA 5050を使った倉庫ロボットの立ち上げ(commissioning)では、単一メッセージのJSON Schema適合だけでは特定できない障害が発生します。個々のorderやstateが構文上は正しくても、複数topicをまたぐ時系列、接続の切り替わり、送信主体、観測漏れを考慮しなければ原因を切り分けられません。
この課題に対して、MQTTトレースから観測事実・仕様上の期待・不足している証拠・次に確認すべき対象を分けて出力するOSS vda5050-lab を実装しました。v0.2.0では再接続診断を対象に、1・2・5・10・50・100台を同じ契約で接続・記録・診断する検証環境を公開しています。
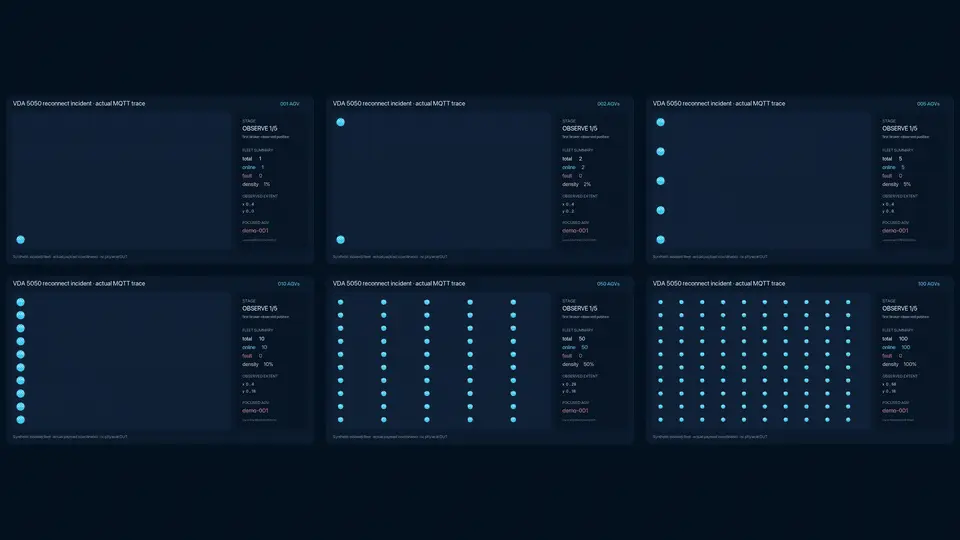 1・2・5・10・50・100台のVDA 5050デモを並べたoverview
対象とする4つの課題
- 単一メッセージの検証では状態遷移を評価できないこと: reconnect、order update、cancel、action lifecycleは複数メッセージの前後関係で決まります。
- 受動ログだけではメッセージの未送信を断定できないこと: キャプチャ開始前の状態、QoS 0の欠落、観測地点の違いを区別する必要があります。
- 多台数環境での識別子(identity)分離: topic、
serialNumber、MQTTClientId、participant、connection epochをロボットごとに分離しなければなりません。 - 表示デモと診断トレースの一致: 画面上の表示を実際のMQTTトレース(canonical trace)から直接描画し、診断器の入力と一致させる必要があります。
アーキテクチャと検証フロー
デモは、隔離したDockerネットワーク内で以下を一気通貫に実行します。
- 使い捨てのEclipse Mosquittoを起動する
- N台の仮想Mobile Robot、Fleet Control、Recorderを同時接続する
- 全ロボットへ固有のVDA
serialNumber、topic、MQTTClientId、order ID、経路を割り当てる demo-001だけを異常切断し、ブローカーのLWTでCONNECTION_BROKENを発行する- 同じparticipantを新しいconnection epochで再接続し、意図的にretained
ONLINEを送らない状態を作る - broker-egressの観測をcanonical traceへ保存する
- ネットワークから隔離したDoctorコンテナ(
network_mode: none)でトレースをオフライン診断する - manifest、trace、evidence、reportの整合性を検証して全コンテナを破棄する
Scenario runner
  └─ Docker internal network
      ├─ Mosquitto
      ├─ Virtual robots × N
      ├─ Fleet actor
      └─ Recorder
            │
            ├─ run-manifest.json
            ├─ trace.canonical.jsonl
            └─ synthetic-evidence.json
                         │
                         ▼ network disabled
                   vda5050-doctor
                         │
                         └─ doctor-report.json
retained messageの残留を防ぐため、台数規模ごと・fault/controlごとに新しいブローカーとネットワークを作成しています。
多台数での識別子(identity)分離検証
このデモではN台すべてが同じブローカーへ同時接続し、それぞれ別のidentityと経路を持ちます。レンダラー上のロボット数だけでなく、run-manifest.jsonとtrace.canonical.jsonlに含まれる固有identity数も検証しています。
| ロボット数 | 同時MQTT接続上限 | 記録されたbroker-egressメッセージ |
|---|---|---|
| 1 | 3 | 10 |
| 2 | 4 | 18 |
| 5 | 7 | 42 |
| 10 | 12 | 82 |
| 50 | 52 | 402 |
| 100 | 102 | 802 |
接続数は「N台 + Fleet Control + Recorder」です。メッセージ上限、60秒の実行時間、actor数、MQTT接続数をrun manifestに固定し、上限を超過した実行は失敗として扱います。
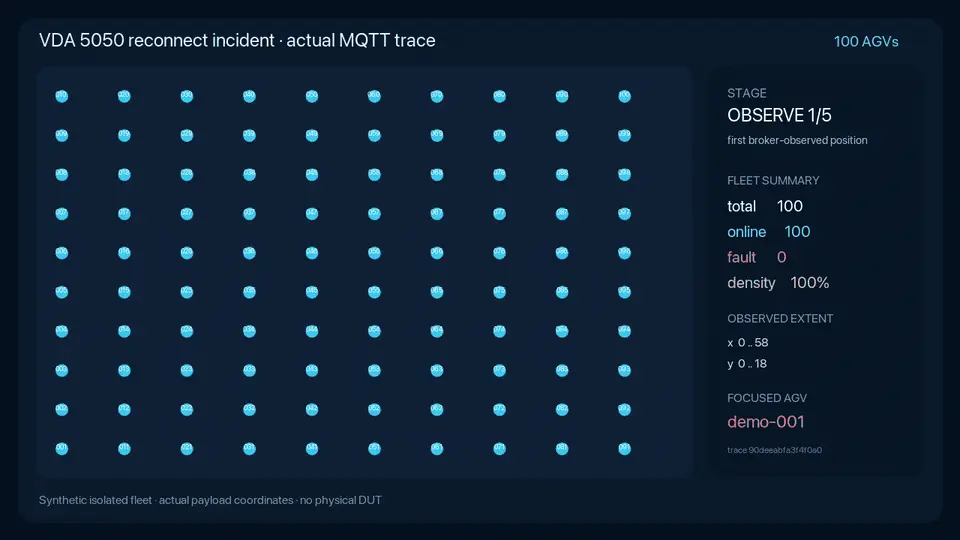 100台の固有identityとx/y経路を表示したVDA 5050デモ
x/y座標と描画の定義
各ロボットの位置は、VDAメッセージ内のマップ座標(mapId: warehouse-demo、単位: メートル、左下原点)として生成します。0始まりのロボットインデックスをiとすると、座標は次の通りです。
column       = floor(i / 10)
row          = i mod 10
start        = (6 × column,     2 × row)
released_end = (6 × column + 4, 2 × row)
horizon_end = (6 × column + 4, 2 × row + 1)demo-001は(0, 0) → (4, 0) → (4, 1)、demo-100は(54, 18) → (58, 18) → (58, 19)を移動します。レンダラーは予定座標ではなく、実際にトレースへ記録されたorder / state / visualizationペイロードのx/y座標を読み取って描画します。
証拠の強さに応じた3段階の判定
診断ルールLAB-D4-RECONNECT-STATEは、VDA 5050 3.0.0のconnection lifecycle(異常切断時のLWT CONNECTION_BROKEN と、再接続時のretained ONLINE 送信)を検証します。同じ異常シナリオでも、Doctorへ渡す証拠の範囲によって判定結果が変わります。
| 入力 | 結果 | 意味 |
|---|---|---|
| subscriberが観測したtraceのみ | INCONCLUSIVE / UNRESOLVED | publisherの役割、connection epoch、キャプチャの完全性が未確定 |
| trace + 同一runのbroker/session evidence | FAIL / MOBILE_ROBOT | 新epochのstate送信を確認した上で、期待するONLINEの欠落を特定 |
| reconnect後にONLINEを送るcontrol trace | D4 findingなし | 再接続後のONLINE送信を正常に観測 |
VDA 5050の主要topicにはQoS 0も含まれるため、受動的なsubscriberログだけで未送信を断定すると、ネットワーク欠落やキャプチャ開始タイミングの問題と混同してしまいます。そこで、生の観測ログ(raw observation)とブローカー側のセッション証跡(evidence manifest)を分離し、SHA-256ダイジェストで紐付ける設計にしました。
実行方法
Docker Composeとjqがあれば手元で再現できます。まず10台構成で動かす場合は以下のコマンドを実行します。
git clone https://github.com/ekusiadadus/vda5050-lab.git
cd vda5050-lab
make demo-fleet DEMO_ROBOTS=10
全6規模(1・2・5・10・50・100台)を一括で実行・検証する場合は次のコマンドを使用します。
make demo-fleet-e2e実行が完了すると、各規模のディレクトリにrun-manifest.json、trace.canonical.jsonl、synthetic-evidence.json、doctor-report.jsonが出力されます。バイナリと全6規模のMP4/GIFは v0.2.0 Release から取得できます。
シミュレーションの前提条件と今後のロードマップ
本デモの100台構成は、隔離されたDocker環境上で100台の仮想MQTTアクターを動かし、識別子の分離と診断契約を検証したものです(実機100台の物理接続や衝突回避・機能安全の試験ではありません)。
v0.2.0で合成トレースによる証拠モデルを一通り検証できたため、今後は匿名化した実環境の障害トレースを対象に、以下の診断ルールを追加していく予定です。
order更新とbase/horizonのつなぎ合わせ(stitching)newBaseRequest、キャンセル、アクションのライフサイクル検証- VDA 5050 v2.1 から v3.0 への移行時の互換性診断
現場の立ち上げエンジニアがログを入力した際に、「何が起きたか」「どのメッセージが根拠か」「どの仕様節に関わるか」「何が未観測か」「次にRobot・Fleet Control・通信のどこを調べるべきか」を即座に返せるツールを目指しています。相互運用性の障害トレースを共有いただける場合は、ぜひ GitHub Issues からご連絡ください。