AIエージェントを増やすと、性能改善の仕事は速くなるのか。Astra単体とAstra+GPT-5.6 Solの協調構成を、ISUCON11予選で比較しました。題材は、椅子の状態データを保存し、履歴やグラフを返すWebサービス「ISUCONDITION」です。機能を保ったまま改善し、ベンチマーカーで正しさと性能を測ります。
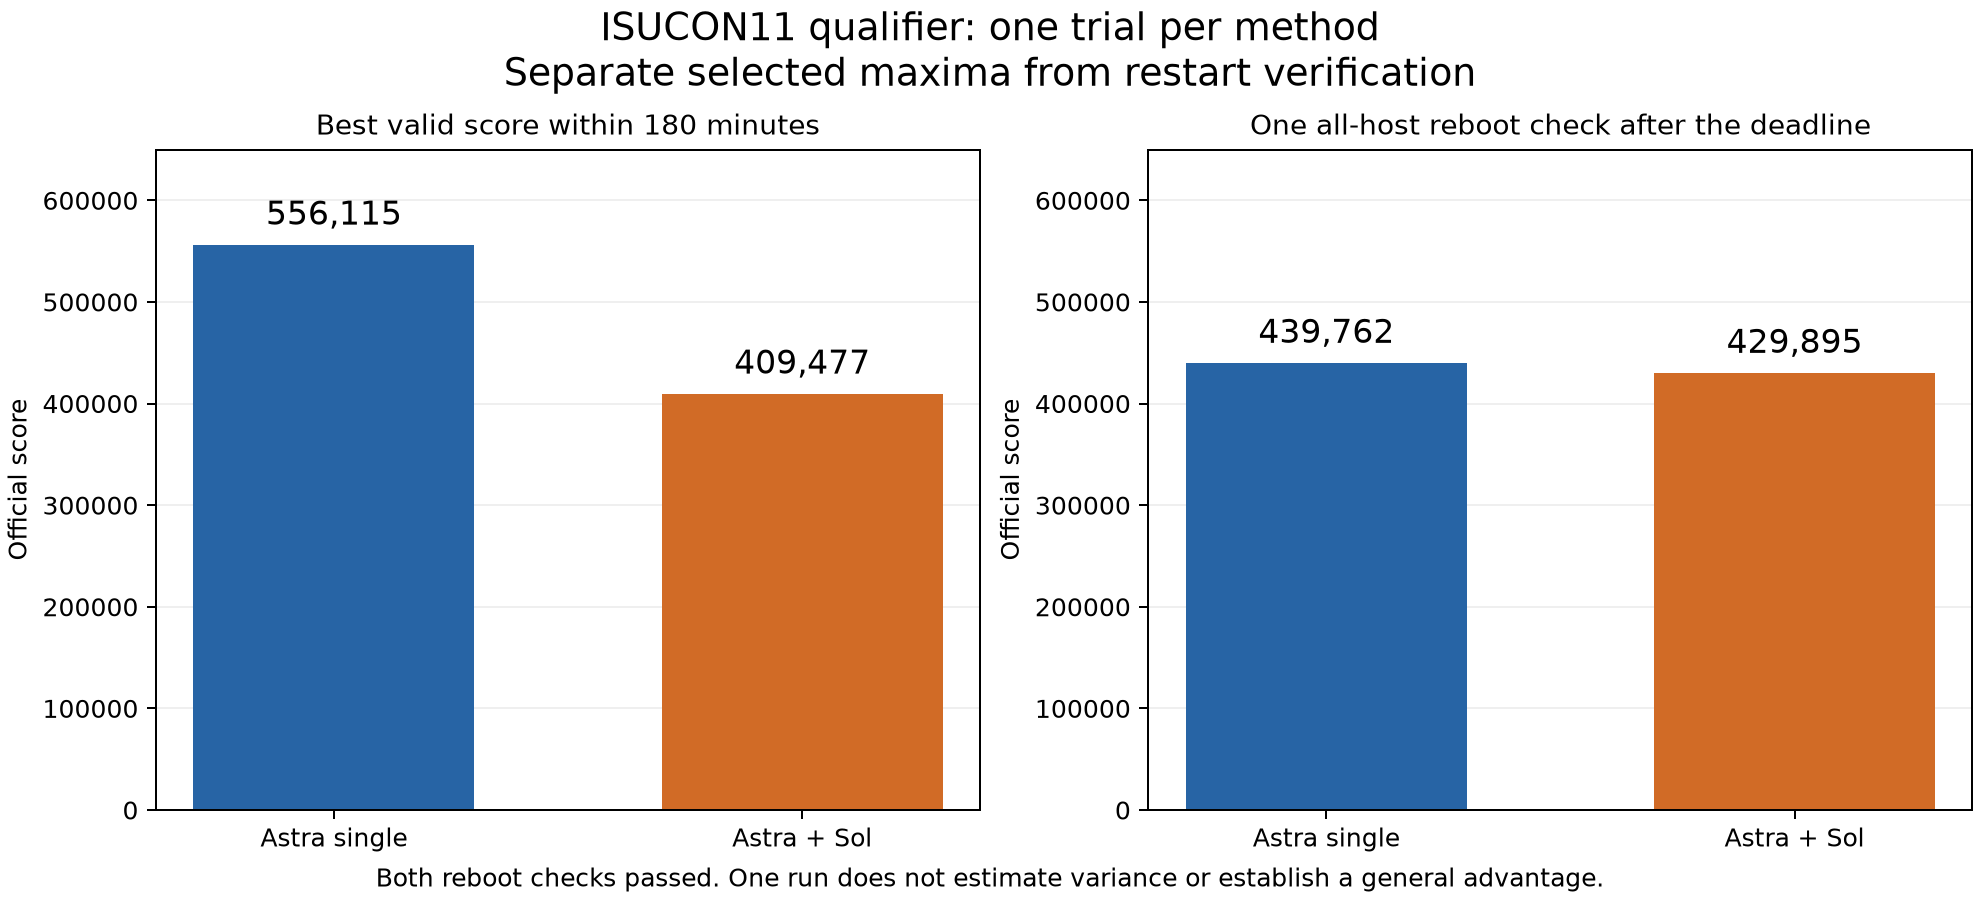
この記事では、Codex Python SDKと隔離ワーカーを使って実施した再実行(2026年9月13日 11:14〜14:14 JST)の結果を先に紹介し、後半に初回(native subagent構成)の実験記録を掲載します。
再実行:最高値では単体が先行、再起動後の差は約2.3%
再実行は11:14:32〜14:14:32 JST、各方式180分・1試行。同じ初期commitから、新しい独立した競技3台+ベンチ1台を各群に割り当て、計8 EC2で同時に走らせました。
| 再実行の指標 | Astra単体 | Astra+Sol |
|---|---|---|
| 初期スコア | 1,627 | 1,843 |
| 時間内の最高有効スコア | 556,115 | 409,477 |
| 最高版の全台再起動後・1回 | 439,762 / pass | 429,895 / pass |
| 通常計測 成功 / 失敗 | 40 / 3 | 23 / 1 |
| 診断計測 完了 / 未完了 | 3 / 1 | 7 / 0 |
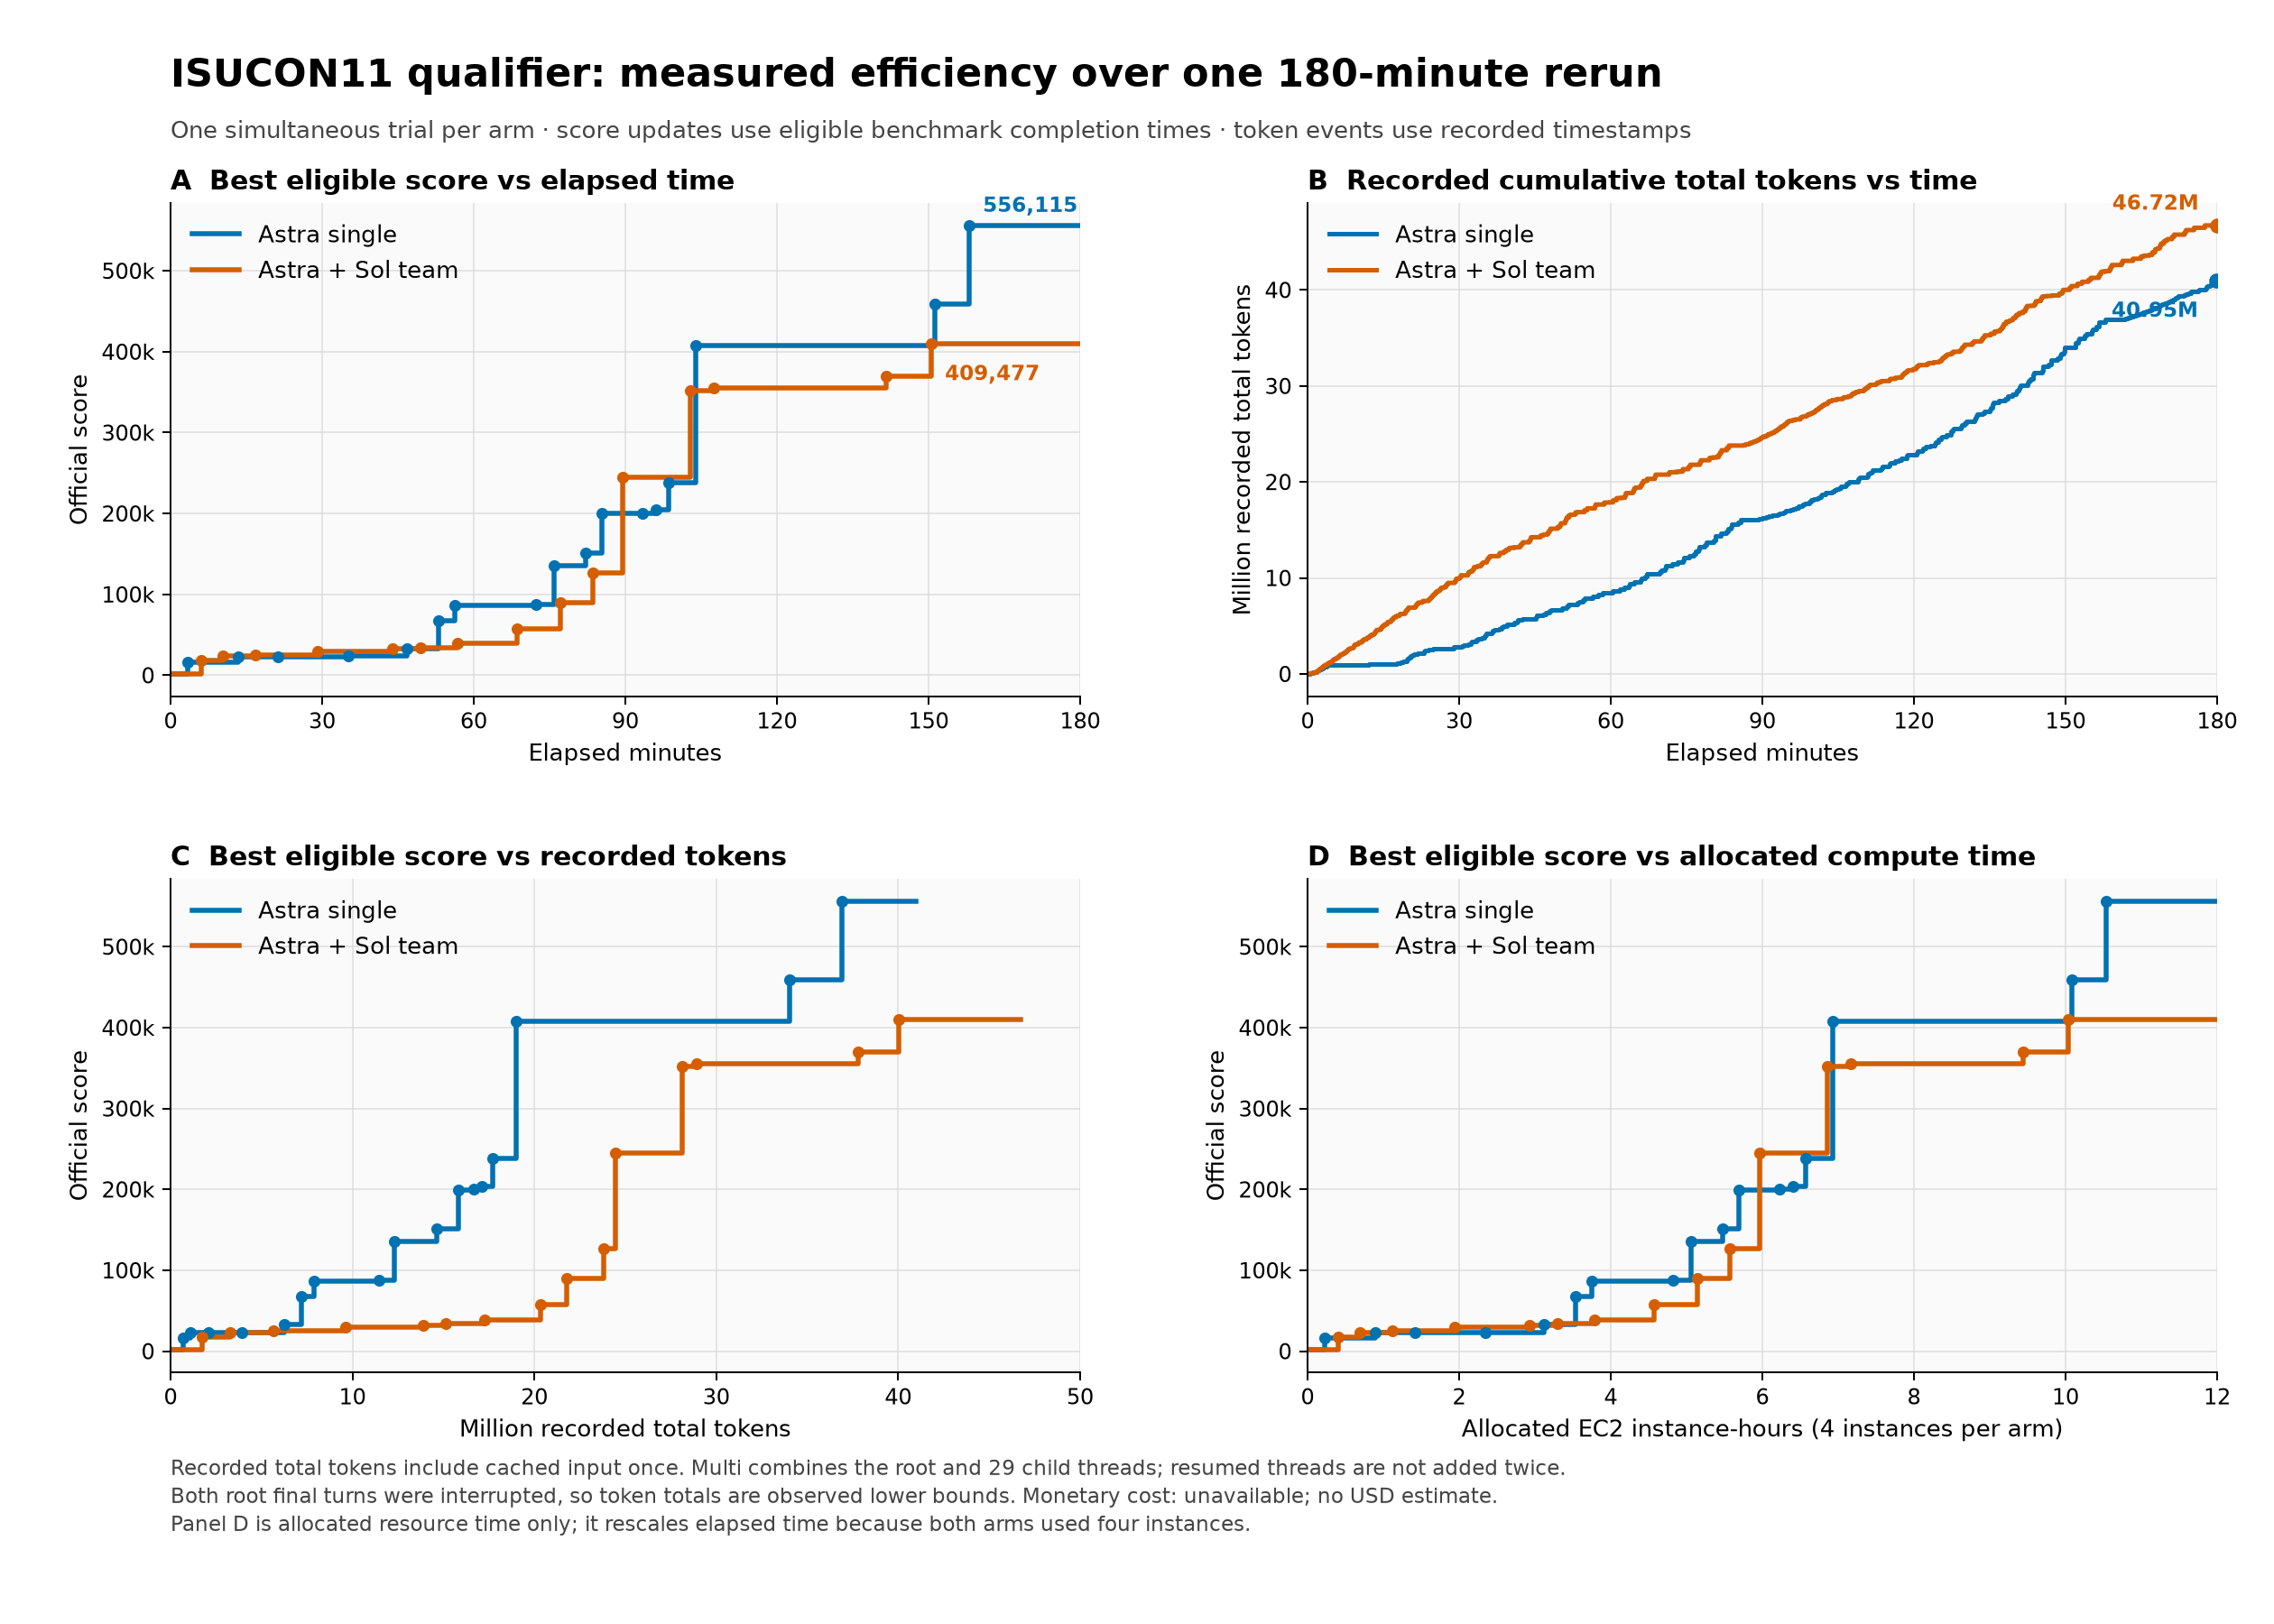
| 記録された総トークン(親+子) | 40,948,900 | 46,719,114 |
| 非キャッシュ入力 | 1,018,380 | 1,718,097 |
| 出力 | 177,176 | 390,713 |
単体は少ない記録トークンでより多くの候補を測定し(40回 vs 23回)、時間内最高スコアは協調群の1.358倍、全台再起動後のスコアは1.023倍(439,762点 vs 429,895点)でした。
再実行で変更した親子エージェントの接続構成
初回はCodex CLIのnative subagentを使いましたが、再実行では公式Codex Python SDK openai-codex==0.154.0 で親Astra/highを動かし、外部のタスク制御器からCodex CLIのSol/high workerを起動する方式へ変更しました。
- 親が短い共通メモ、仮説、基準commit、担当ファイル、検証方法をタスク台帳へ登録する。
control.pyが専用cloneのSol workerを最大2体まで起動。指定ファイル以外の書込み、Gitメタデータへの書込み、ネットワークをOS sandboxで制限する。- 子は差分と根拠を返す。親が範囲を検査してcommitし、独立レビューを記録する。
- 親が
experiment.pyへ候補を渡す。ホスト側brokerは固定された操作を受け付け、配備・初期化・実行バイナリ照合・ベンチ・回収・復元を環境ごとに排他実行する。 - 採用で基準版を更新。古い候補は現行基準の新attemptで作り直し、同じ仮説・基準版の修正は同じthreadを再利用する。
初回のworktreeと指示中心の分離から、書込み範囲・通信禁止を実行環境で強制する構成へ変更しました。実測では29子スレッド、34呼び出し(新規29+再開5)、最大同時2体が稼働しました。
再実行で見つかった28分間のワーカー枠占有
隔離の検査に通っても、仕事の配分が効率的とは限りませんでした。
group-commit-reviewは変更のない読み取りレビューでしたが、終了後もステータスが prepared のまま残りました。制御器は running / prepared / quarantined を同時上限へ数えるため、1枠を28分00秒にわたって占有し、追加レビューの起動が2回 worker capacity reached で拒否されました。その後、親が別候補を採用して古い基準版のタスクが stale になったことで枠が解放されました。
次に改善すべきポイントは、差分0の読み取りレビューを受領した時点で完了状態へ遷移させることと、実行中ワーカー枠と未評価パッチ枠を分離することです。
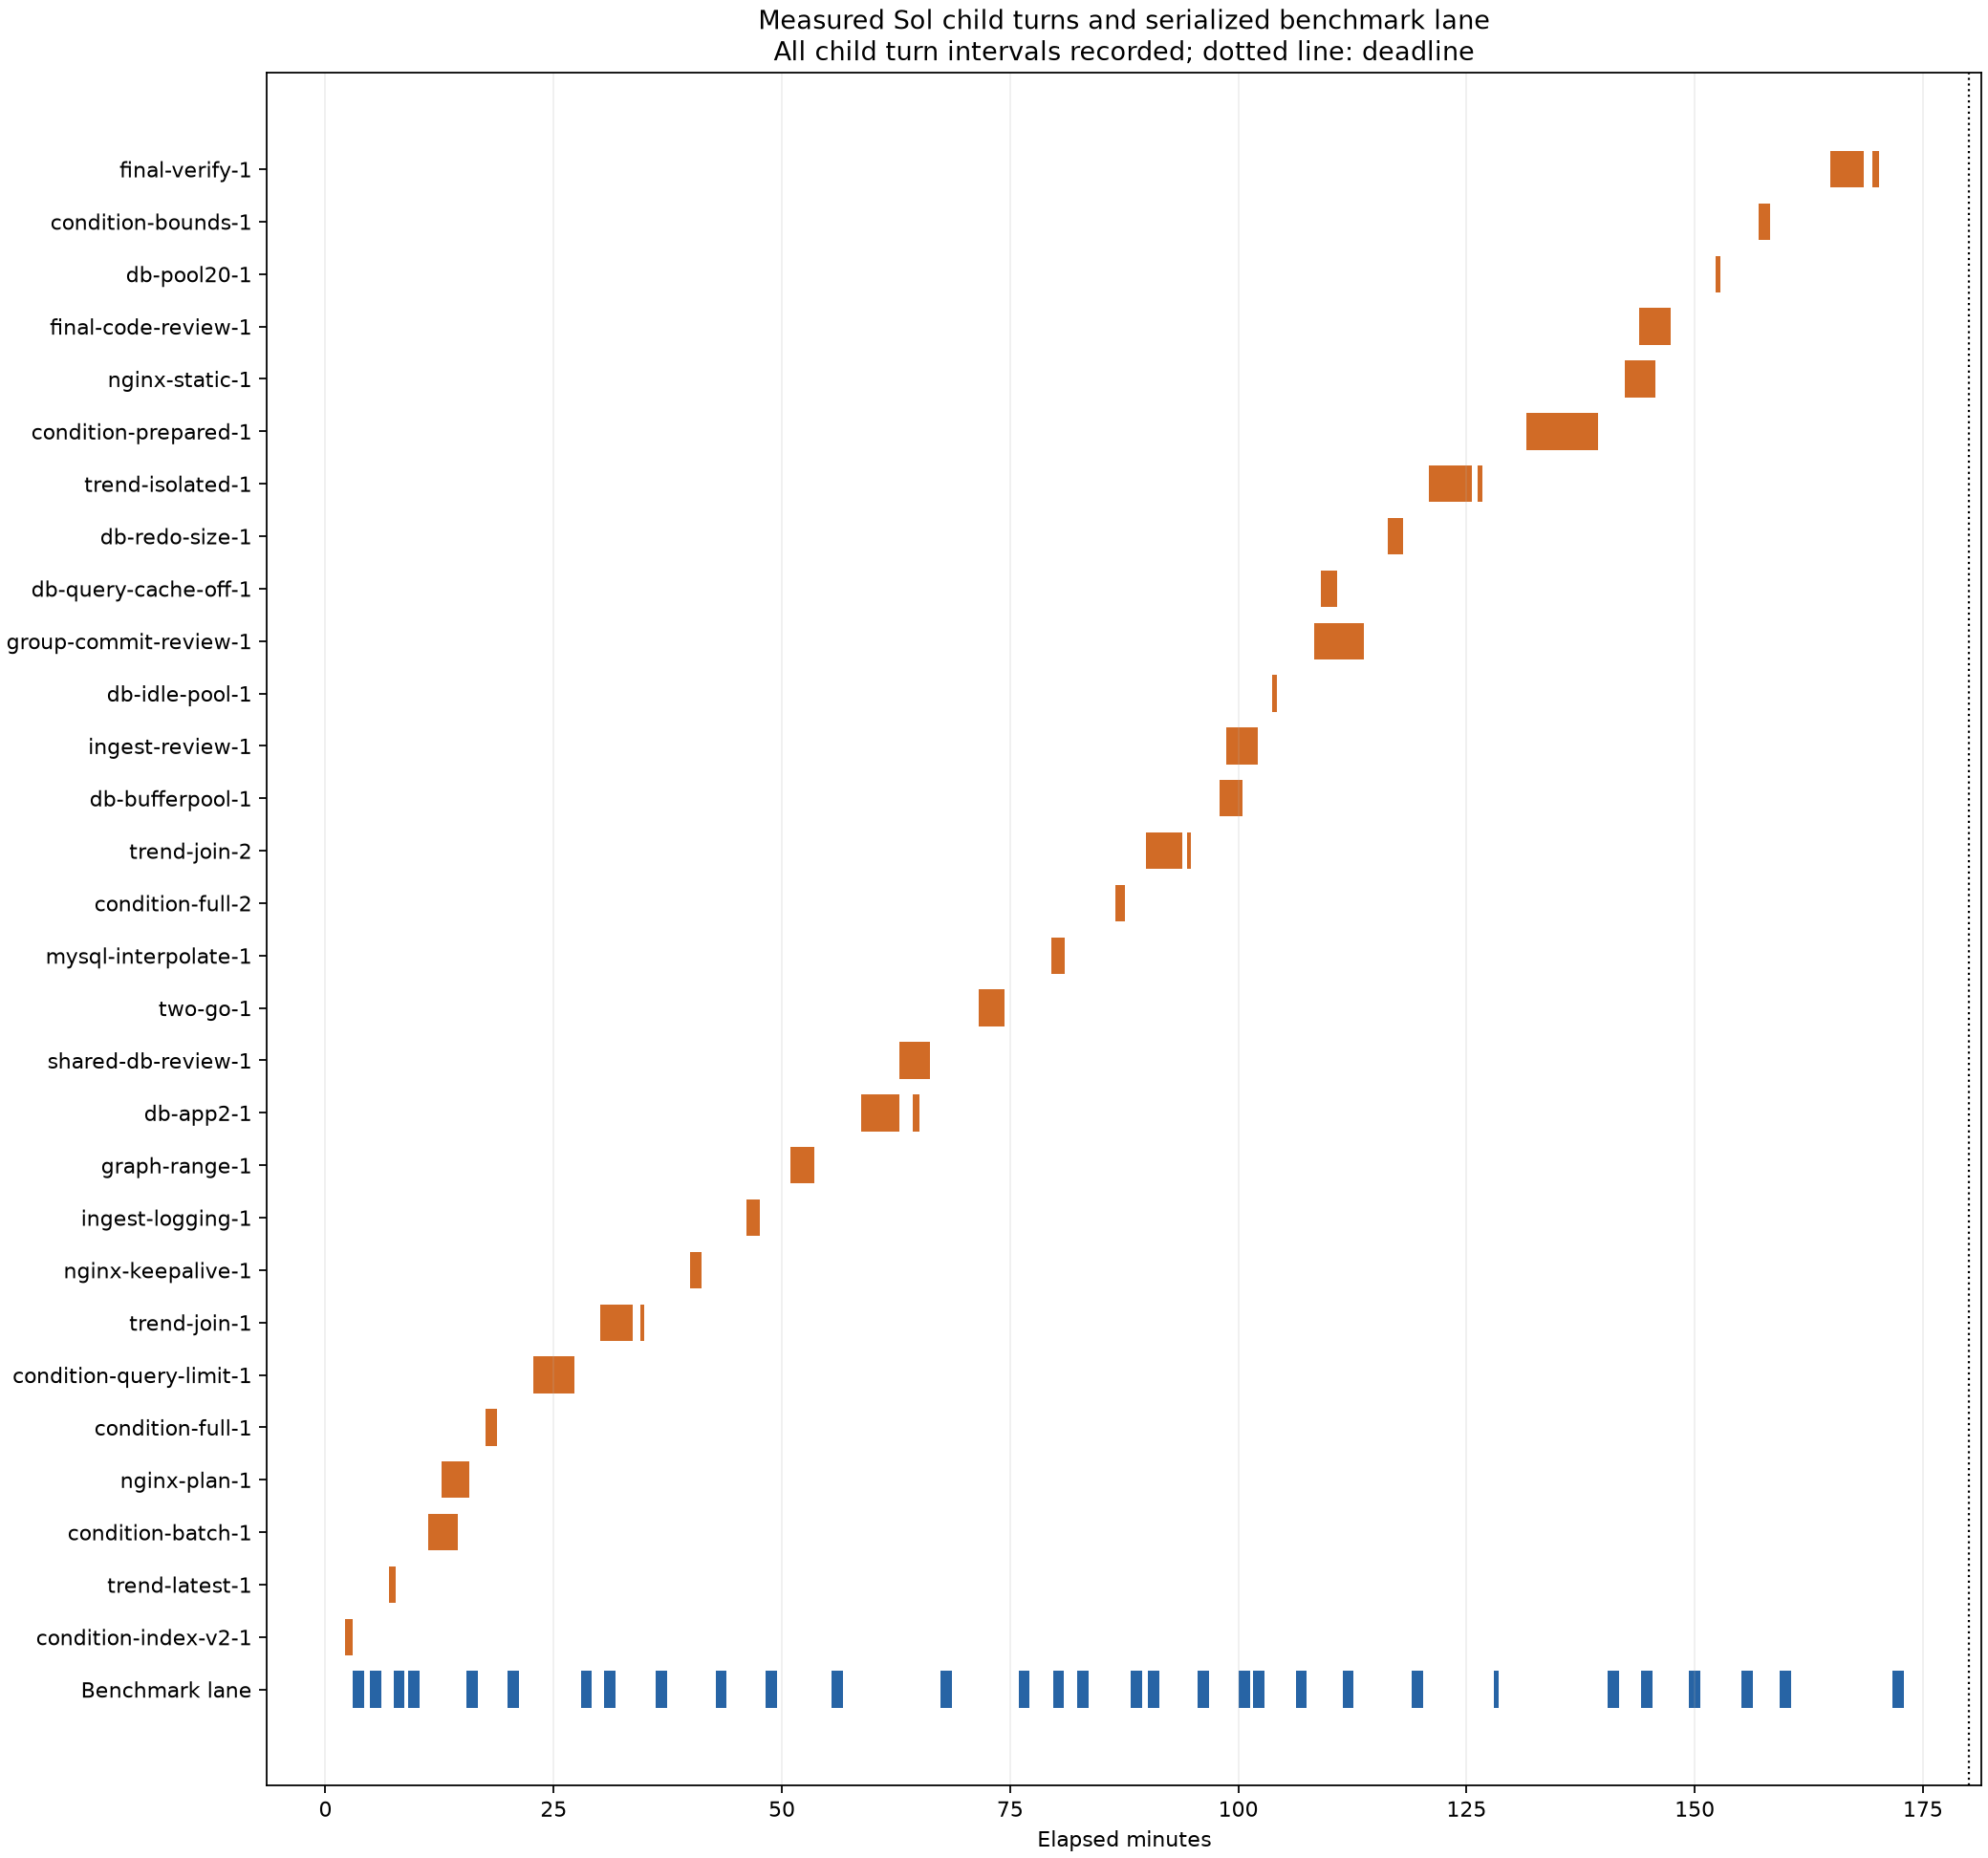
子が1体以上動いたのは約74.15分、2体が重なったのは約8.00分でした(2枠×180分に対する子の延べ稼働率は約22.8%)。
再実行の到達速度とコンテキスト消費
| 到達スコア | 単体 | 協調 |
|---|---|---|
| 10万 | 75.84分 | 83.56分 |
| 25万 | 103.98分 | 102.84分 |
| 50万 | 158.08分 | 未到達 |
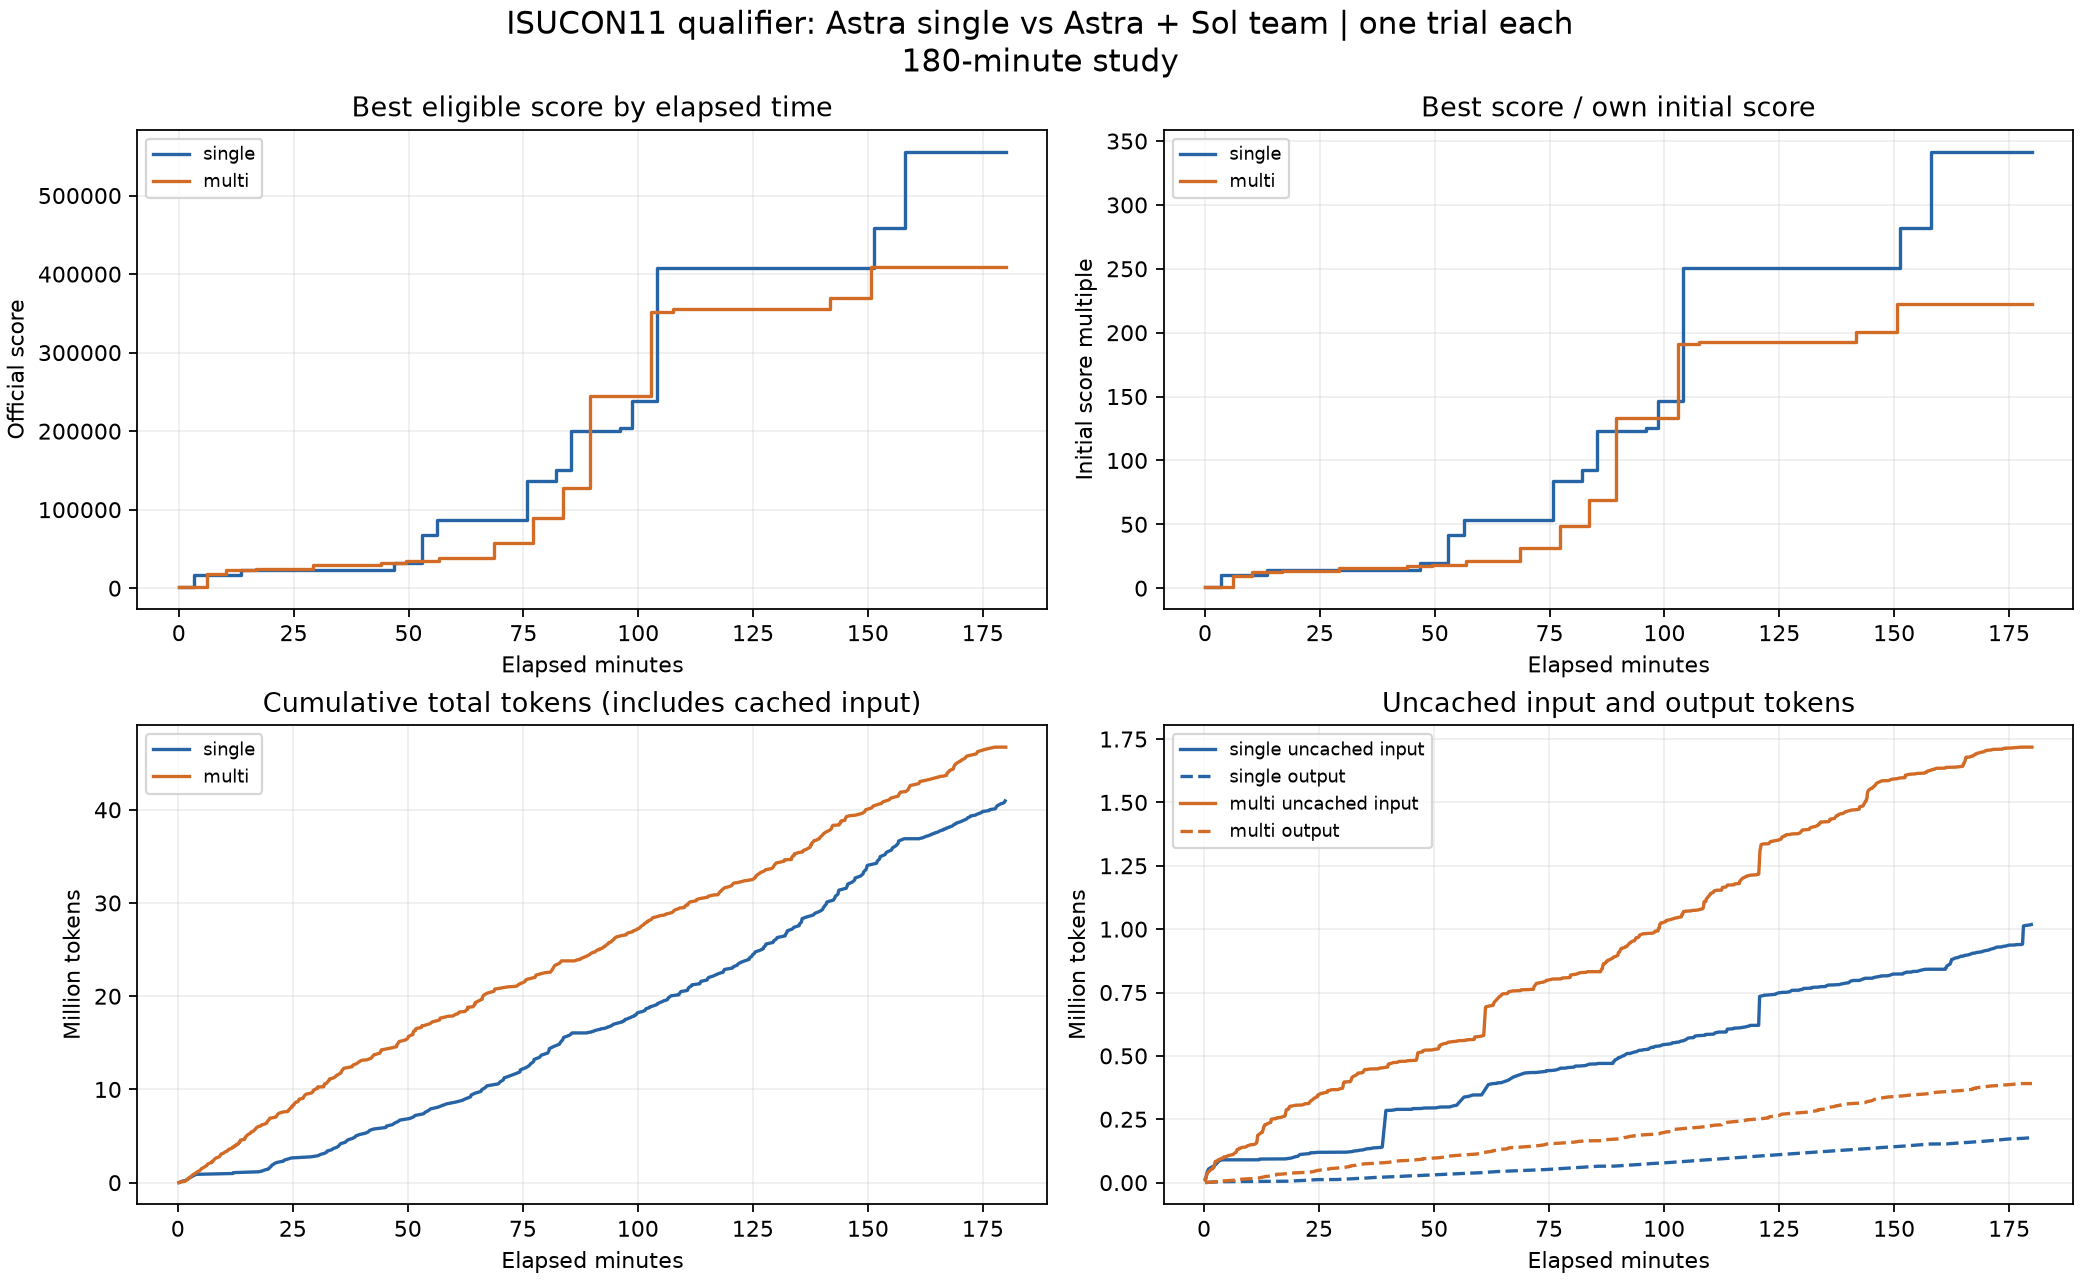
25万への到達は協調群が約1.1分早く、10万と50万では単体が先行しました。協調群の実験キュー待ちは合計約61秒でした。
子の1リクエストあたり最大入力は53,083トークン、親は244,705トークンでした。協調群の記録総トークンは親41,049,771、子合計5,669,343で、全体の約87.9%を親が消費しています。子のコンテキストを小さく保てても、親の統合・レビュー負荷を減らさない限り全体のトークン消費と試行回数は改善しないことが分かります。
スコア・トークン・EC2割当時間の推移
次の図は再実行の180分について、経過時間に対する最高有効スコア、累積記録トークン、消費済みトークンに対する到達スコアを並べたものです(拡大PNG / PDF / 集計CSV)。
再実行の振り返り:何がボトルネックだったのか
公式Codex SDKドキュメントの通り、Python SDKはローカルのCodex app-serverをJSON-RPCで制御する仕組みです。今回の再実行では単体・協調とも同じSDK上で動かしており、差が出た原因はSDK自体ではなく、自作したタスク台帳・レビュー制御にありました。
| 観測された事象 | 原因の所在 | 次の改善策 |
|---|---|---|
| 完了した読み取りレビューが28分間枠を占有 | coordinatorの状態遷移設計 | 差分0のレビュー受領時に即座に完了へ遷移させ、実行枠と未評価パッチ枠を分離する |
| 子2体の同時稼働が約8分間にとどまった | タスク分割・依存関係・起動判断 | 親がベンチ測定を待つ間に、次の独立仮説1〜2件を子に先行調査させる |
| 親が記録総トークンの87.9%を消費 | 親への判断・統合・レビューの集中 | ビルド・テスト・機械的な差分チェックをスクリプト側で自動判定する |
| 協調群の通常合格ベンチが23件(単体は40件) | 候補作成から検証までの直列待ち | 統合・レビューの往復回数を減らし、時間あたりのベンチ試行数を増やす |
| 時間内最高値 | 初回(native subagent) | 再実行(SDK + 隔離worker) |
|---|---|---|
| Astra単体 | 1,621,980 | 556,115 |
| Astra+Sol | 1,114,247 | 409,477 |
再実行の公開データとして、公開用集計JSON、全run CSV、図のSHA-256を添付しています。実験終了後、8台のEC2と関連EBS・セキュリティグループ・キーペアはすべて破棄(destroy)しました。
初回の記録:2026年9月13日00:09〜03:09 JST(native subagent構成)
以下は初回のnative subagent構成(Codex CLIの組み込みサブエージェント機能)での3時間比較実験の記録です。Astra単体と、AstraがGPT-5.6 Solのサブエージェントを統括する協調構成を、同じ初期コードから3時間ずつ動かして比較しました。
再起動後の最終スコアは、単体が 1,636,308、複数が 885,334(単体が約1.85倍)でした。一方で、複数側は50万点に約27分早く到達しています。
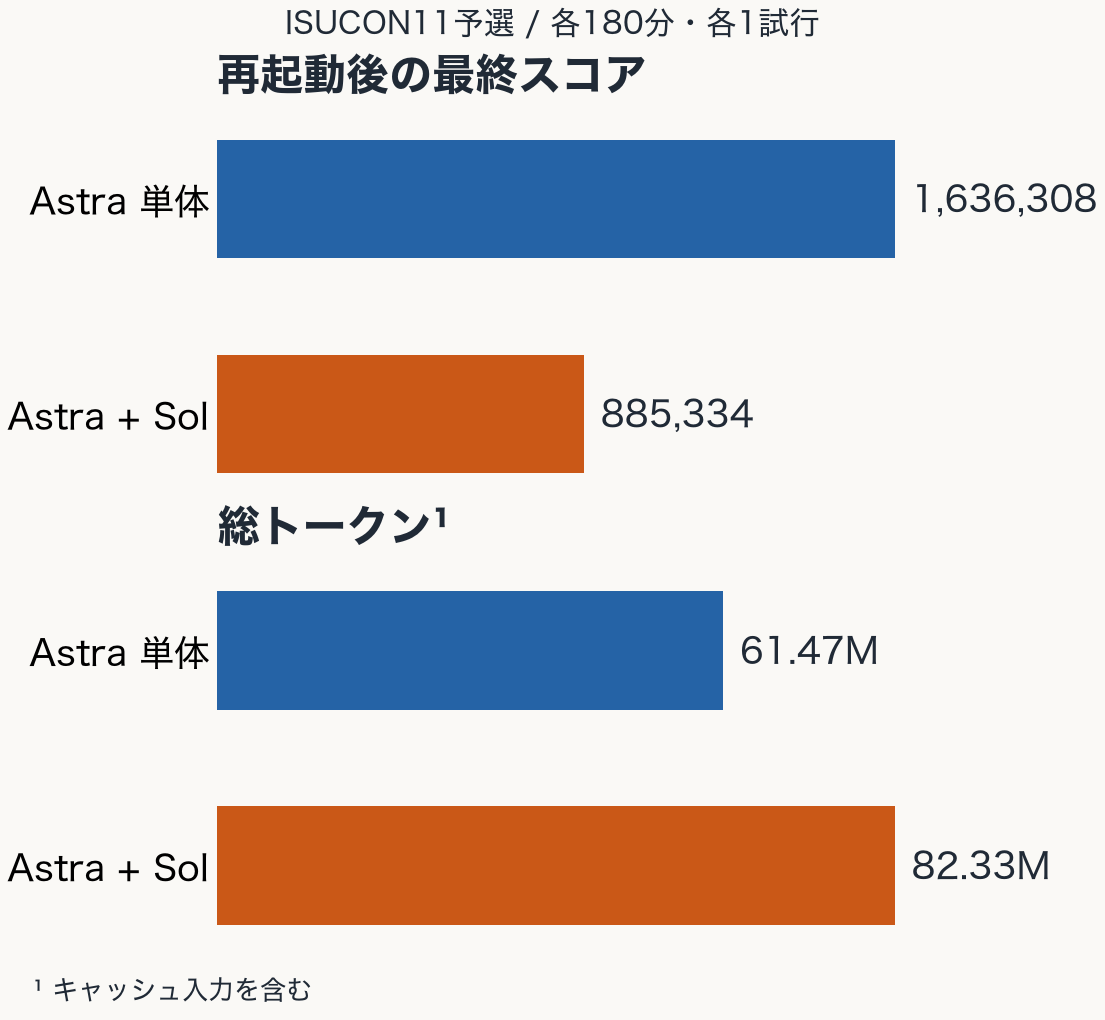
題材:ISUCON11予選(ISUCONDITION)
実測対象は ISUCON11予選(ISUCONDITION) です。椅子から届く状態データを保存し、履歴・グラフ・全体の傾向を表示するWebサービスで、継続的な書込みと集計・読取りを同時にさばく必要があります(公式アプリケーションマニュアル)。
実験環境:8台のEC2による同時走行
両方式に競技用3台(c5.large ×3)とベンチ用1台(c4.xlarge ×1)をそれぞれ用意し、片方の負荷やDB変更がもう片方に混ざらない構成にしました。
| 条件 | 単体 | 複数協調 |
|---|---|---|
| 親モデル | Astra / high | Astra / high |
| 子モデル | なし | GPT-5.6 Sol / high |
| 時間 | 180分 | 180分 |
| 競技用EC2 | c5.large ×3 | c5.large ×3 |
| ベンチ用EC2 | c4.xlarge ×1 | c4.xlarge ×1 |
| 初期コード | 0652d01d2699 | 0652d01d2699 |
ISUCON11の公式構成およびmatsuu氏の復元環境を使い、全8台を同じAZ・gp3 20GB(3,000 IOPS・125 MiB/s)で揃えています(初期スコアは1,678対1,874)。
複数側のタスク分割と計測パイプライン
複数側には以下の運用ルールを与えました。
- 最初にDB、API・仕様、実行時負荷を分担して調査する
- 実装は検証可能な仮説ごとに分け、同時2件まで(サブエージェント全体の同時上限は5)
- 実装担当は別のGit worktreeを使い、親が差分をレビューして統合する
- 配備・初期化・ベンチ・ログ回収は、環境ごとに排他ロック(
flock)を通す
| 担当 | 役割 | 出力 |
|---|---|---|
controller.py | 開始時刻・期限・モデル設定・初期指示でCLIを起動 | 親thread、JSONLイベントログ |
| 親Astra | 観測から仮説を選び、子を起動・連絡し、差分をレビュー・統合 | 子への限定タスク、実験に出すcommit |
| 子Sol | 担当範囲の調査、専用worktreeでの実装、または差分レビュー | 結論、根拠ファイル、候補commit |
executor.py | 親から候補commitを受け取り、環境別ロック内で配備・計測 | run ID、score、messages、ログ |
session_audit.py | 保存された親子関係、モデル、tool呼出し、usageを集計 | 稼働子数・並列区間・トークン集計 |
起動時のCLI設定(抜粋)は以下の通りです。
model = "gpt-6-astra"
model_reasoning_effort = "high"

[agents]
enabled = true
max_concurrent_threads_per_session = 5
default_subagent_model = "gpt-5.6-sol"
default_subagent_reasoning_effort = "high"
親は collaboration.spawn_agent(fork_turns="none")で子を起動し、会話履歴全体ではなく担当タスクのスコープ(目的・基準commit・対象パス・根拠ログ・禁止事項)だけを渡します。実際のログではspawn 24件、send 22件でした。実機へのデプロイとベンチマーク実行は親だけが ./experiment.py candidate --commit COMMIT_SHA を通じて行います。
スコア推移:中盤は複数が先行し、終盤に単体が逆転
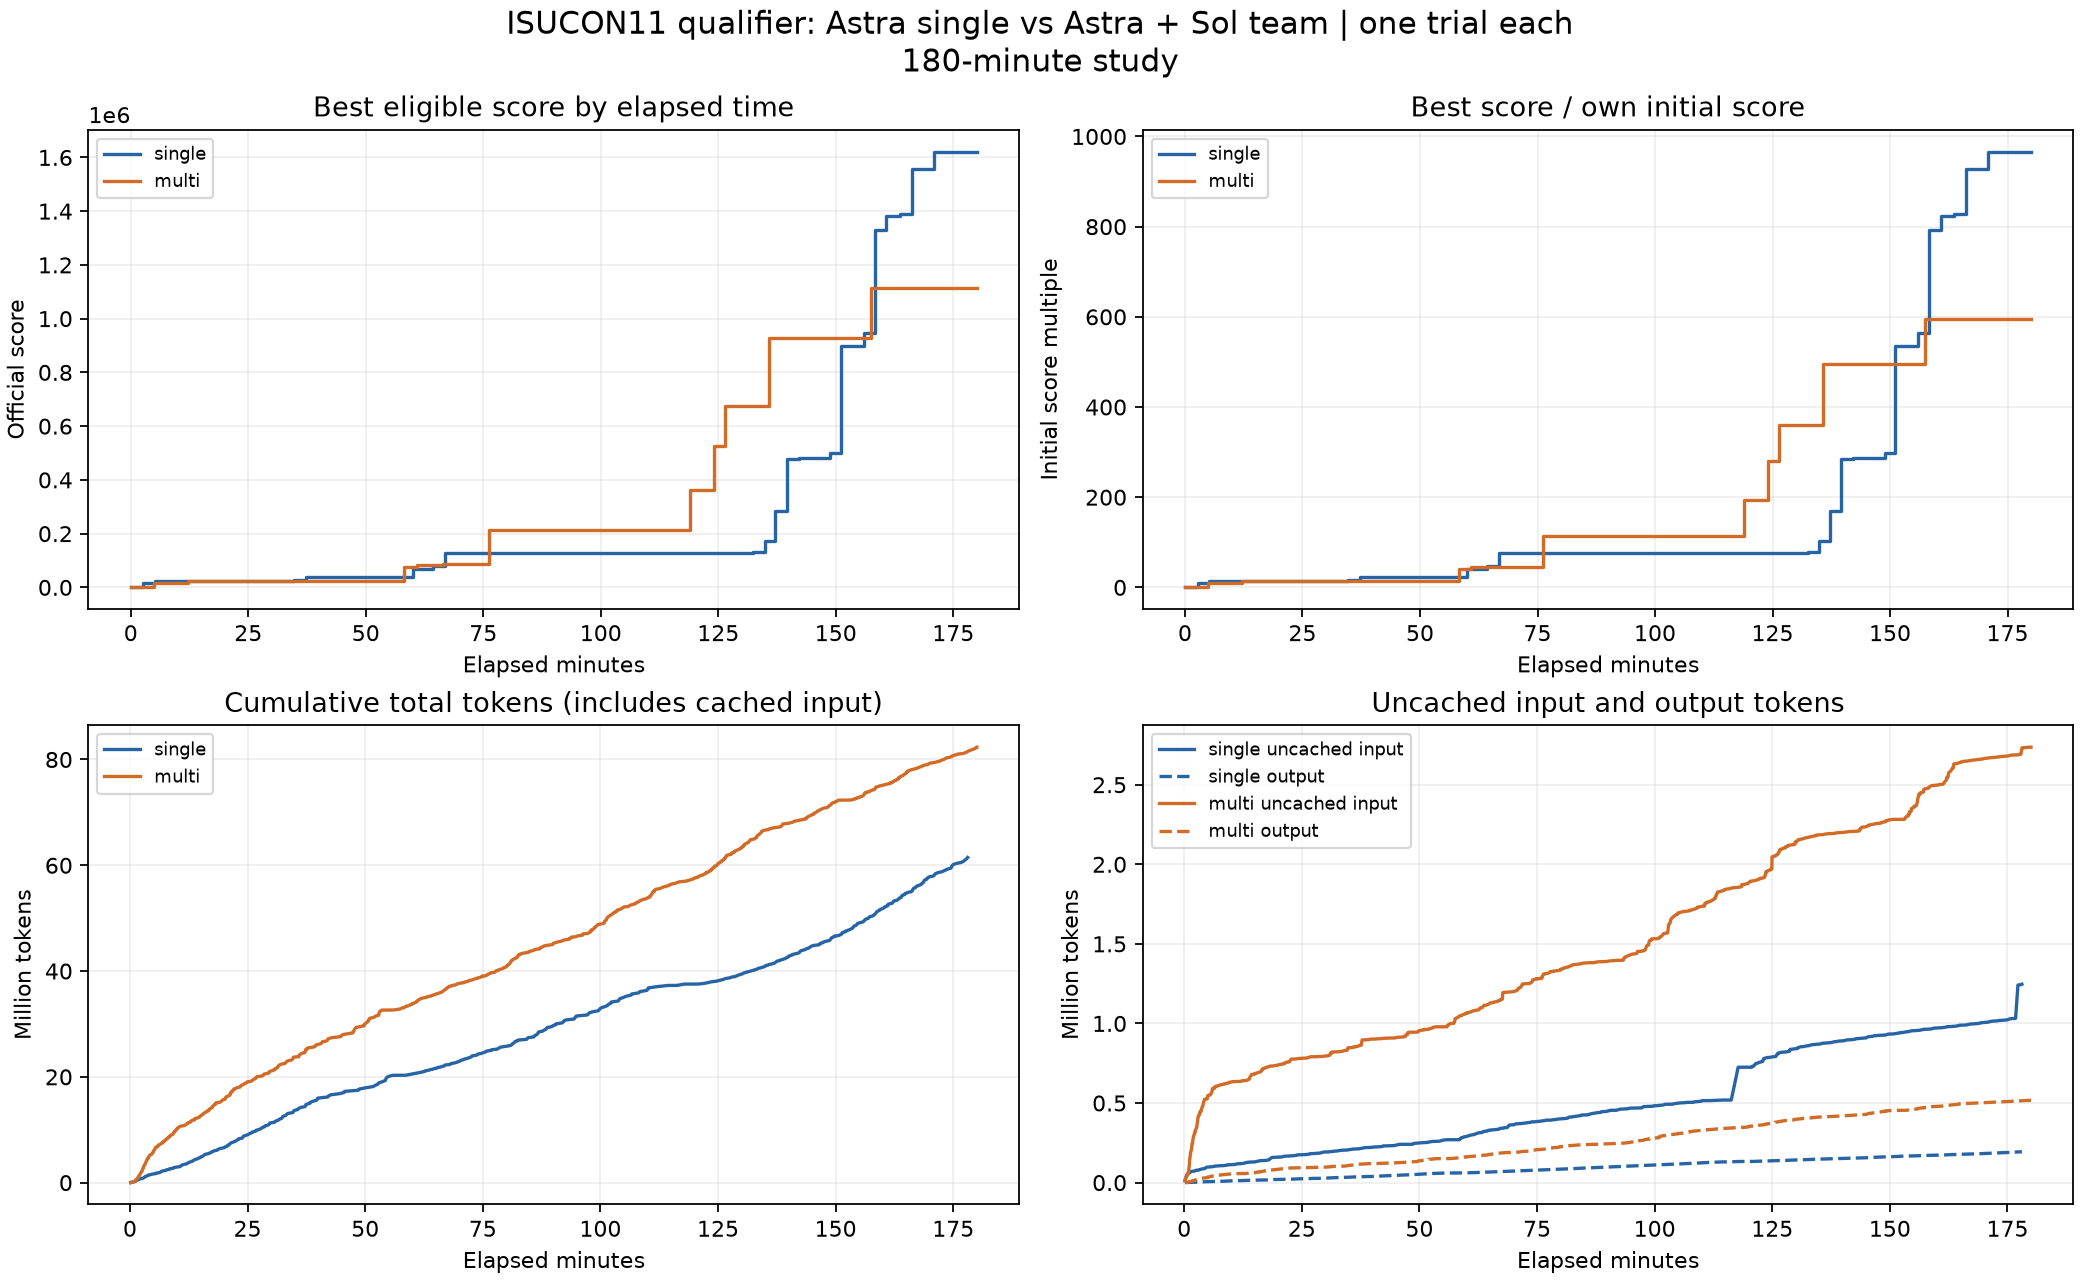
| 到達点 | 単体 | 複数 |
|---|---|---|
| 1万点 | 0:02:43 | 0:04:51 |
| 5万点 | 1:00:02 | 0:58:14 |
| 10万点 | 1:06:47 | 1:16:09 |
| 25万点 | 2:17:10 | 1:58:54 |
| 50万点 | 2:31:05 | 2:04:05 |
| 100万点 | 2:38:23 | 2:37:29 |
複数は50万点に約27分早く到達しました。100万点では差が54秒に縮まり、その後は単体が大きくスコアを伸ばしています。時間内の最高合格スコアを時間積分(AUC)して180分で割ると、単体316,651に対して複数は370,073(+16.9%)でした。
両者が最終的に選んだアーキテクチャも異なっています。
| 項目 | 単体の選定版 | 複数の選定版 |
|---|---|---|
| 書込み | 複数書込みをtransactional LOAD DATAにまとめ、commit後に応答 | conditionを100件単位のtransactionでINSERT |
| 配置 | app3がDB、app2が取込み、app1がmetadata/trendを担当 | conditionをapp2/app3のDBへ分割、metadataはapp2、appは3台 |
| 読取り | 条件index、列削減、trend 16秒cache、Gob payload再利用 | 条件index、graph列削減、trend 250ms cache、icon LRU/ETag |
| 選定commit | 0e2a05019f66 | 9e7dae4eee86 |
時間内最高点と再起動後スコア
| 走行 | 単体 | 複数 |
|---|---|---|
| 3時間内の最高通常点 | 1,621,980 | 1,114,247 |
| 同じ選定commitの終了前確認 | 1,608,134 | 654,392 |
| 再起動後の最終点 | 1,636,308 | 885,334 |
ISUCON11のレギュレーションに合わせ、全サーバー再起動後のベンチマーク結果を最終スコアとしました。両方ともpass=trueでしたが、複数側には通信エラー9件とtimeout 71件(減点16点)が発生し、885,334点となりました。
トークン消費量の内訳
| 使用量 | 単体 | 複数の親Astra | 子Sol合計 | 複数全体 |
|---|---|---|---|---|
| input | 61,273,760 | 54,406,272 | 27,412,204 | 81,818,476 |
| cached input | 60,027,392 | 53,330,048 | 25,752,320 | 79,082,368 |
| uncached input | 1,246,368 | 1,076,224 | 1,659,884 | 2,736,108 |
| output | 193,901 | 208,014 | 308,477 | 516,491 |
| reasoning output | 96,503 | 103,446 | 108,485 | 211,931 |
| total | 61,467,661 | 54,614,286 | 27,720,681 | 82,334,967 |
複数側の親の入力トークンは単体より11.2%少なくなりましたが、子Solを合算すると 総トークンは34%増、非キャッシュ入力は約2.20倍、出力は約2.66倍 となりました。全24個の子エージェントそれぞれでマニュアルやコードの読取りが発生するため、親のコンテキストを圧縮できてもシステム全体のトークン量は増えています。
サブエージェント24体の稼働タイムライン
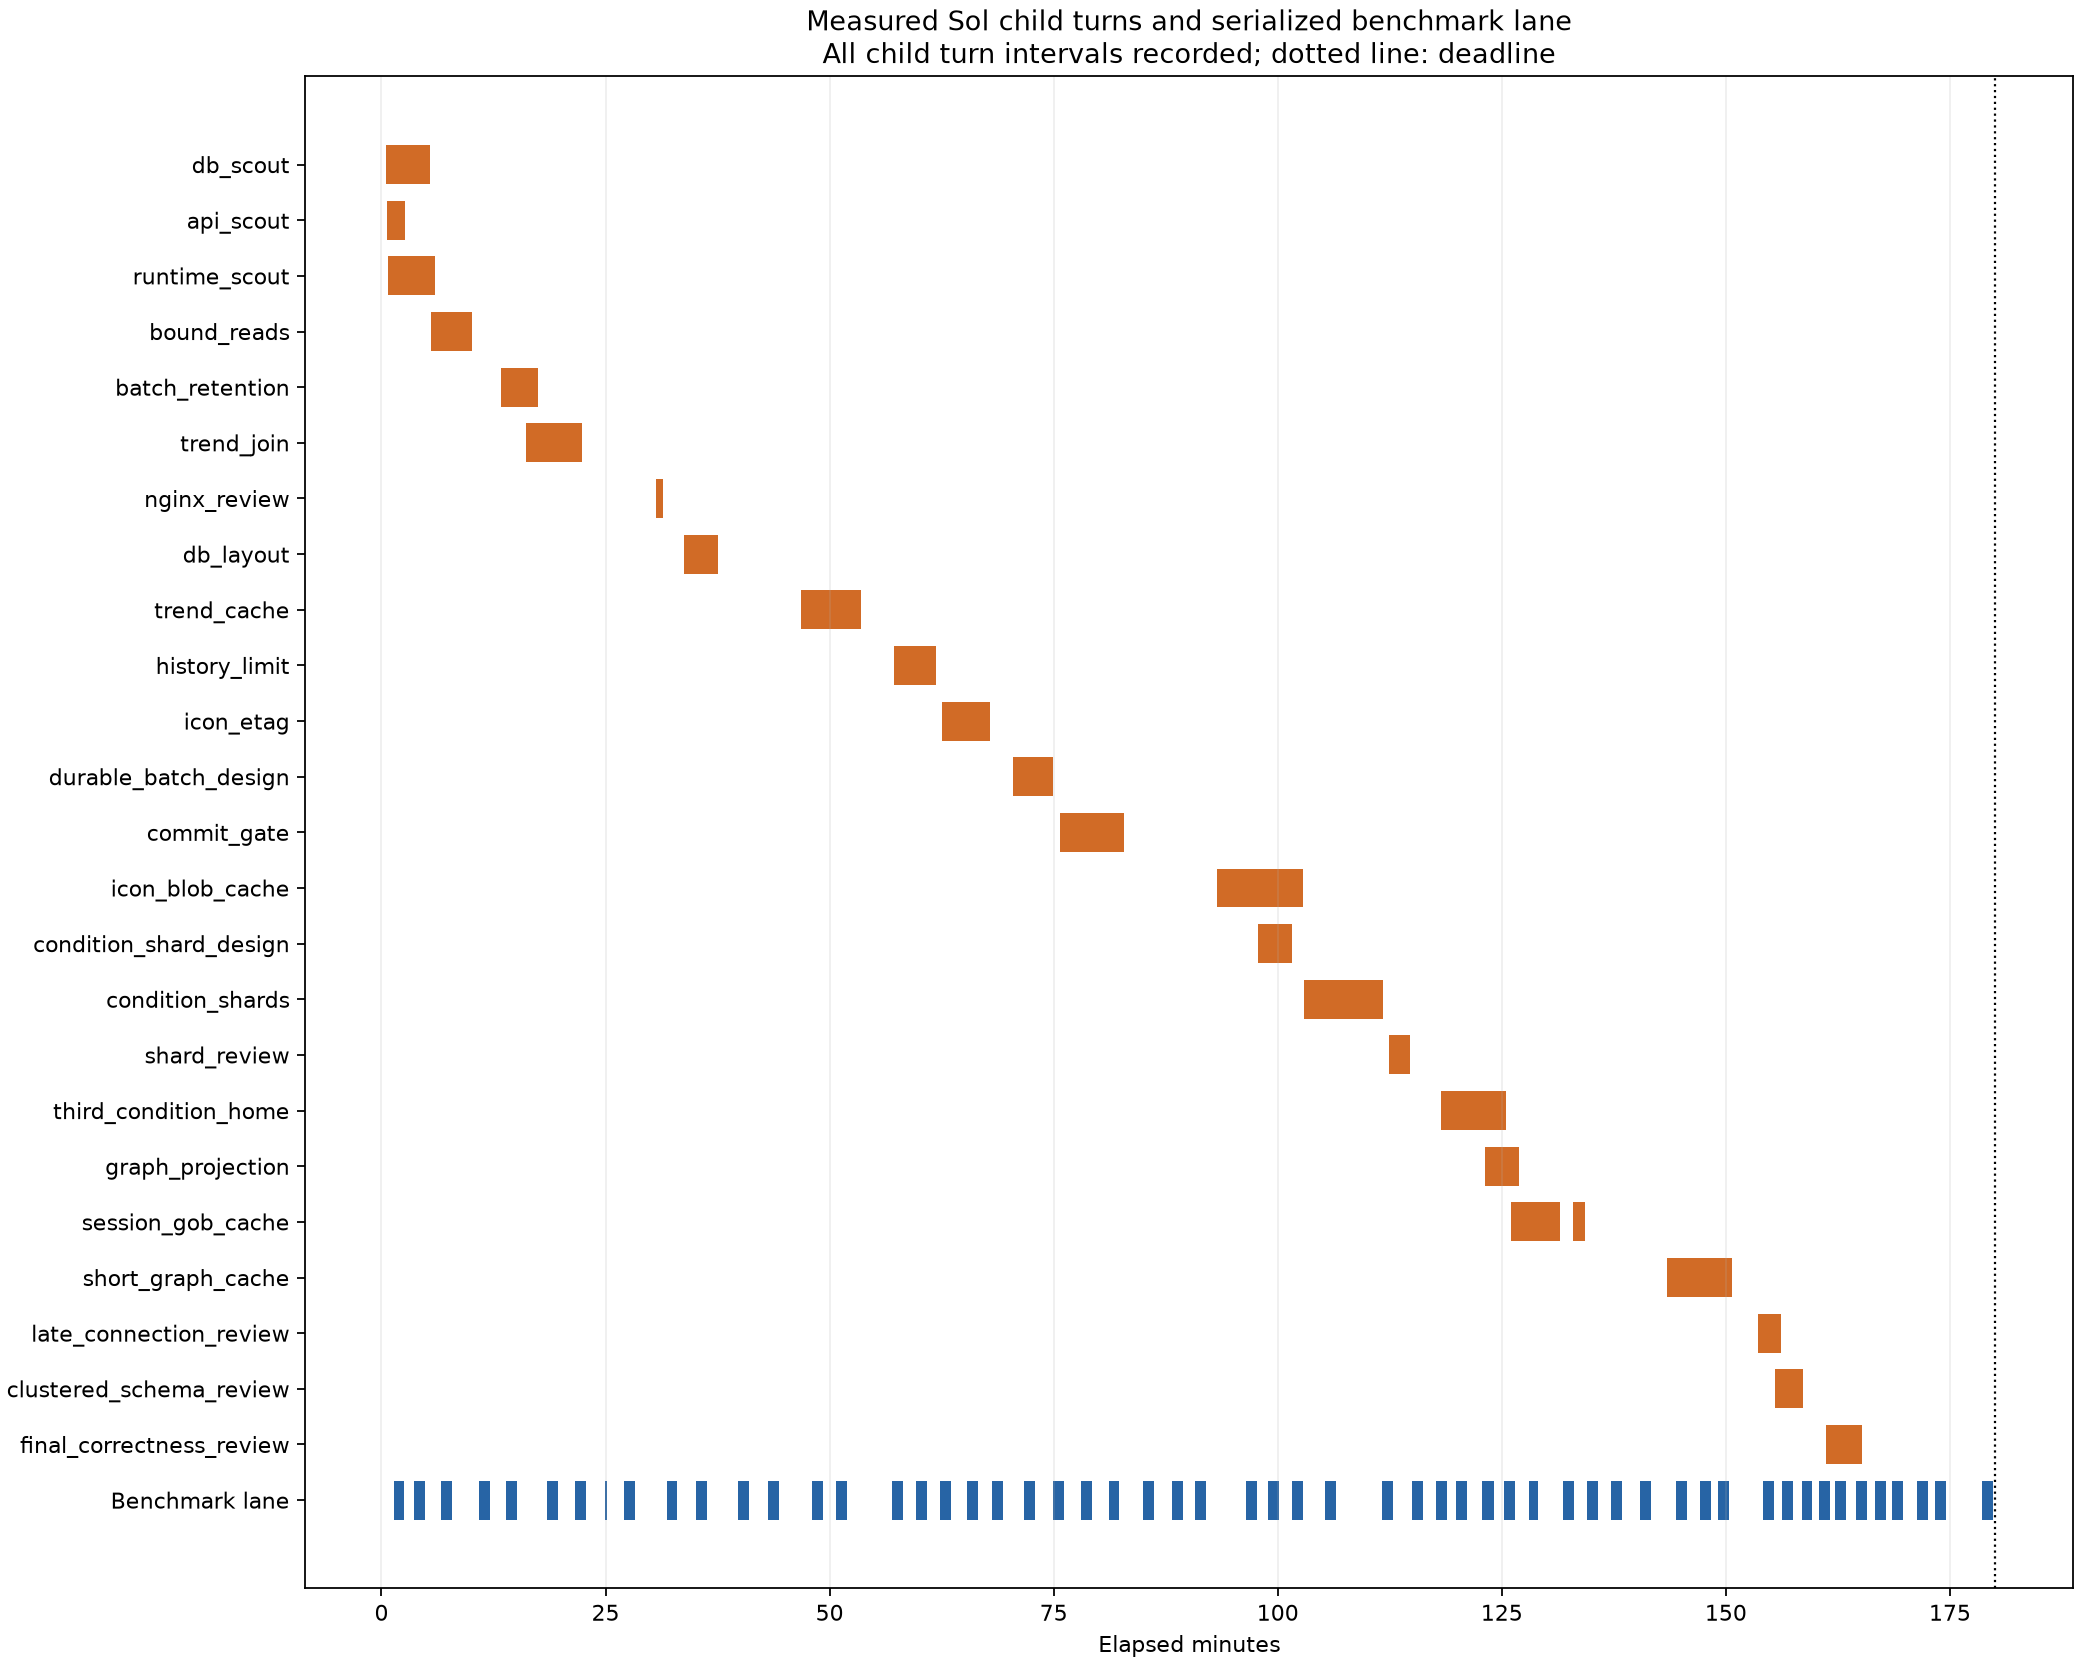
橙が各子エージェントの稼働区間、最下段の青がベンチマーク走行です。冒頭の3つの調査タスクは並列に動いていますが、その後は子が1体ずつ動く区間が多くなっています。
- 起動された子エージェントは計24スレッド(最大同時実行は3体)
- 180分のうち、子0体が76分49秒、1体が88分39秒、2体以上が14分32秒(平均稼働子数は0.665体)
| 実験の進み方 | 単体 | 複数 |
|---|---|---|
| 候補実行 | 56 | 56 |
| 通常合格 | 50 | 46 |
| 診断走行 | 4 | 8 |
| 不合格 | 2 | 2 |
| 通常合格 / 時 | 16.67 | 15.33 |
| 最高点更新回数 | 24 | 11 |
| ベンチ実行器の使用時間 | 87.25分 | 85.54分 |
考察と公開データ
今回の2回の実験(初回のnative subagent構成、および冒頭のSDK+隔離worker構成)を通じて、以下の傾向が一貫して見られました。
- 序盤〜中盤の探索速度はマルチエージェントが速い: 初期調査や独立した改善(インデックス追加・N+1解消・基本的なキャッシュ)を分担することで、中盤のマイルストーンには複数構成が先に到達しました。
- 終盤の密結合なアーキテクチャ変更では単体モデルが強い: 複数台へのDB分割やバッチ書込みなど、アプリケーション全体とインフラ設定を同時に揃える変更では、単一の強モデルが一貫したコンテキストで実装・検証する方が手戻りが少なく、最終スコアでも上回りました。
実験の集計データとして、初回集計JSON、全候補スコアCSV、図のSHA-256一覧を公開しています。