今回のCodex構成は、Claudeの過去記録のスコアに届きませんでした。 ただ、ログと実装を詳しく調べるほど「Claudeのモデルが強いから」という一言で片付けるべきではないことが見えてきました。ハードウェアとMySQL永続化の条件が異なり、一方で私たちの改善内容とマルチエージェントの協調制御には、次に直せる具体的なボトルネックが見つかりました。
2026年9月14日、ISUCON14を題材にAstra単体とAstra+GPT-5.6 Solの協調構成を、独立したAWS環境で各3時間・各1回、同時実行しました。時間内最高合格スコアは単体133,401点、協調48,123点でした。Claude側は過去に記録していたスコア台帳・設定・変更履歴と照合しています(前回のISUCON11比較とは別の問題・別の実験です)。
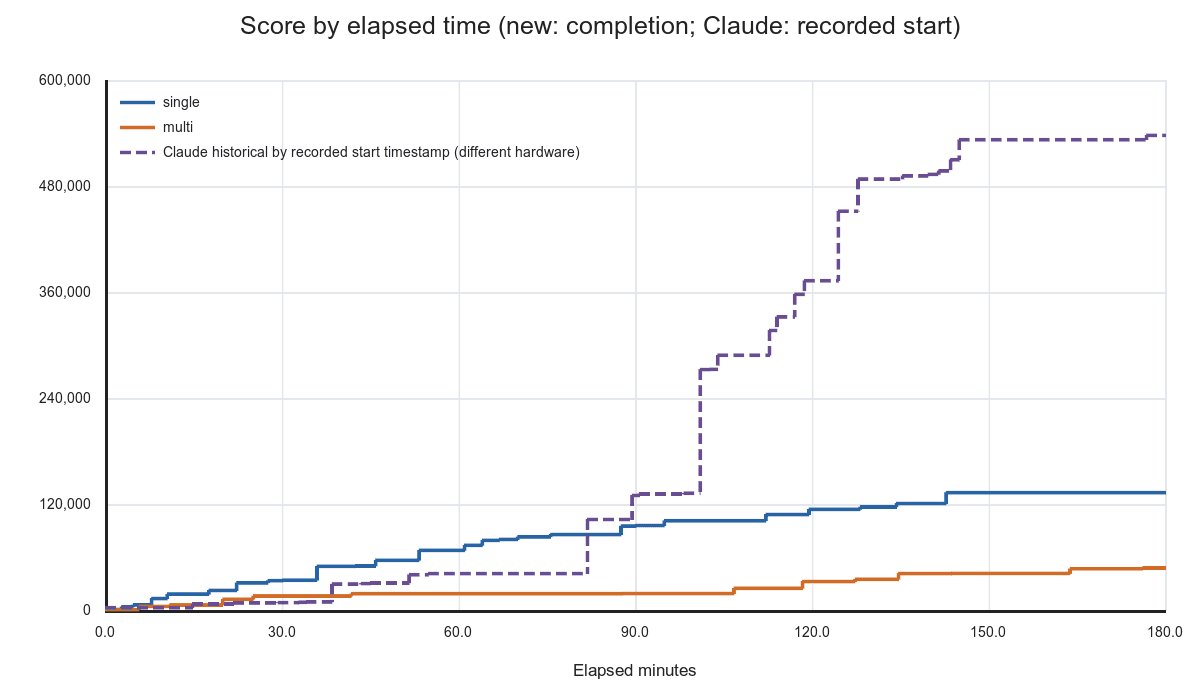 今回のAstra単体・協調と、Claude過去記録の時間対スコア推移
ISUCON14(ISURIDE)は何を速くする問題か
ISUCONは、Webサービスの機能を保ちながら限られたサーバー資源で性能を改善する競技です。ISUCON14の題材「ISURIDE」は、利用者と椅子型の車両をマッチングする配車サービスでした。
位置情報の更新、配車マッチング、乗車状態の通知、決済、履歴や売上の集計が同時に動きます。通知のたびに何度もDBへ問い合わせたり、位置情報を1件ずつ書き込んだりすると、配車を増やしたところでDBが詰まります。単発のSQLを速くするだけでなく、1回の乗車を完了するまでに必要なDB往復・書き込み回数そのものを減らすことが鍵になります。
今回の試行には公式アプリの初期版、マニュアル、ベンチマーク結果だけを渡しました。
実行条件とスコアの比較
| 指標 | Astra単体 | Astra+Sol協調 | Claudeの過去記録(参考) |
|---|---|---|---|
| 初期スコア | 1,117 | 971 | 3回平均3,091 |
| 180分内の最高合格スコア | 133,401 | 48,123 | 537,835(開始時刻ベース) |
| 再起動後スコア | 126,549(合格) | ベンチ未完了 | 966,809(別条件の長時間試行) |
| アプリ用EC2 | c5.large×3 | c5.large×3 | c7a.large×3 |
| ベンチ用EC2 | c5.2xlarge | c5.2xlarge | c7a.2xlarge→後半にc7a.4xlarge |
| 記録合計token | 58,501,615 | 68,658,038 | 記録なし |
今回の実験枠は00:16:12〜03:16:12 JSTの180分間で、各群にアプリ3台+ベンチ1台を割り当てました(ベンチプロセスのメモリ上限は8 GiB)。過去のClaude試行はインスタンス世代(c7a 系)や永続化設定が異なるため、単純なモデルランキングではなく「3時間内にどのボトルネックまで解消できたか」を比較します。
序盤の立ち上がりと中盤以降の伸び
上のスコア推移グラフを見ると、今回のAstra単体は10,000点に7.83分、50,000点に35.91分で到達しています(Claudeの過去記録ではそれぞれ38.47分、81.85分)。つまり「Codexは初期調査が遅くて手が動かなかった」わけではありません。
差が開いたのは中盤以降です。Claudeの過去記録では約1時間22分に103,038点、約1時間41分に272,757点、約2時間08分に488,400点へ伸びているのに対し、今回のAstra単体は94.90分で100,000点に到達したあと、133,401点で頭打ちになりました。最初のインデックス追加の速さよりも、途中からどこまでDB書き込みと状態管理の構造を変えられたかが分かれ目になっています。
差を生んだ3つの技術的要因
1. 1乗車あたりのDB往復・書き込みの削減幅
Claudeの過去履歴では、開始3時間以内に以下のステップを踏んでいました。
| 経過時間 | 変更内容 | 合格スコア |
|---|---|---|
| 0:51:34 | rides.status カラムを持たせ、状態取得クエリを削減 | 40,498 |
| 1:21:51 | ライドと状態遷移をプロセス内メモリに保持 | 103,038 |
| 1:41:00 | 通知をSSE化 | 272,757 |
| 2:07:47 | 中間状態での rides テーブル更新を削減 | 488,400 |
今回のAstra単体・協調も、インデックス追加、N+1削減、一括マッチング、SSE、距離の永続集約、DBの別ホスト分離までは到達しています。さらに単体側は座標のまとめ書き、通知確認のまとめ書き、椅子統計の永続集約、椅子認証キャッシュも実装していました。
それでも差が残ったのは、通知の未送信状態や中間ステータスの更新で毎回SQLを発行する経路が残っていたためです。SSEやキャッシュを入れたかどうかだけでなく、1乗車が完了するまでに残っているDB書き込み回数をどこまで削れたかがスコアに直結していました。
2. MySQLの永続化設定(innodb_flush_log_at_trx_commit)の差
過去のClaude環境では innodb_flush_log_at_trx_commit=2、binlog無効、buffer pool 2 GiB、redo log 1 GiB、最大接続数1,024が設定されていました。一方、今回のAstra単体・協調はbinlogこそ無効化したものの、innodb_flush_log_at_trx_commit=1(コミットごとにディスクへflush)を維持していました。
MySQL公式ドキュメントの通り、1 と 2 では書き込みトランザクションが多いワークロードでのディスクI/O待ちが大きく変わります。次回比較する際は、この永続化条件を揃えて測定する必要があります。
3. 3台構成のうち app3 を活用しきれていなかった
今回の最終構成では、両方式とも app1 がnginx+Go+matcher、app2 がMySQLを担当し、app3 にはワークロードが割り当てられていませんでした(過去のClaude構成では app3 にnginx・TLS終端・静的配信を分離していました)。
最高スコアを記録したrunでのCPU使用率(各ホスト17サンプルの平均)を見ると、ボトルネックの所在がはっきり分かります。
| ホストと役割 | Astra単体(CPU busy) | Astra+Sol協調(CPU busy) |
|---|---|---|
app1:nginx+Go+matcher | 47.3% | 39.3% |
app2:MySQL | 78.3% | 85.1% |
app3:未使用 | 1.7% | 2.2% |
app1 よりも app2(MySQL)のCPU負荷が支配的であり、DB負荷の削減と app3 への役割分散の双方が残されていました。
マルチエージェント協調(Astra+Sol)が単体に負けた理由
今回の3時間枠で完了した通常の合格ベンチマーク回数は、Astra単体が 47回 だったのに対し、Astra+Sol協調は 21回 にとどまりました。
親Astraは公式Codex Python SDK(0.154.0)でスレッドを維持し、外部coordinatorから子ワーカー(Sol / high)を専用Git cloneとOSサンドボックス内で起動する構成を取りました(計27子スレッド・31回実行、最大同時2体)。
しかし、実験中に自作のcoordinatorとexecutorの境界で2件の制御不具合が発生しました。
| 発生した不具合 | 原因 | 影響 |
|---|---|---|
| 準備失敗時のレスポンスと台帳の不整合 | executorのエラー応答にmanifestフィールドがなく、coordinatorが例外終了 | タスクが measuring のまま残り、約13.4分間測定が停止 |
| 同一スレッドの修正候補でGit refが衝突 | 保存用refにturn番号が含まれず、fetchがnon-fast-forwardで失敗 | 候補ブランチの復旧に時間を要した |
また、トークン消費量を比較すると、子ワーカーへ渡すコンテキストを小さく絞っても、親エージェント自身のトークン消費が減っていないことが分かりました。
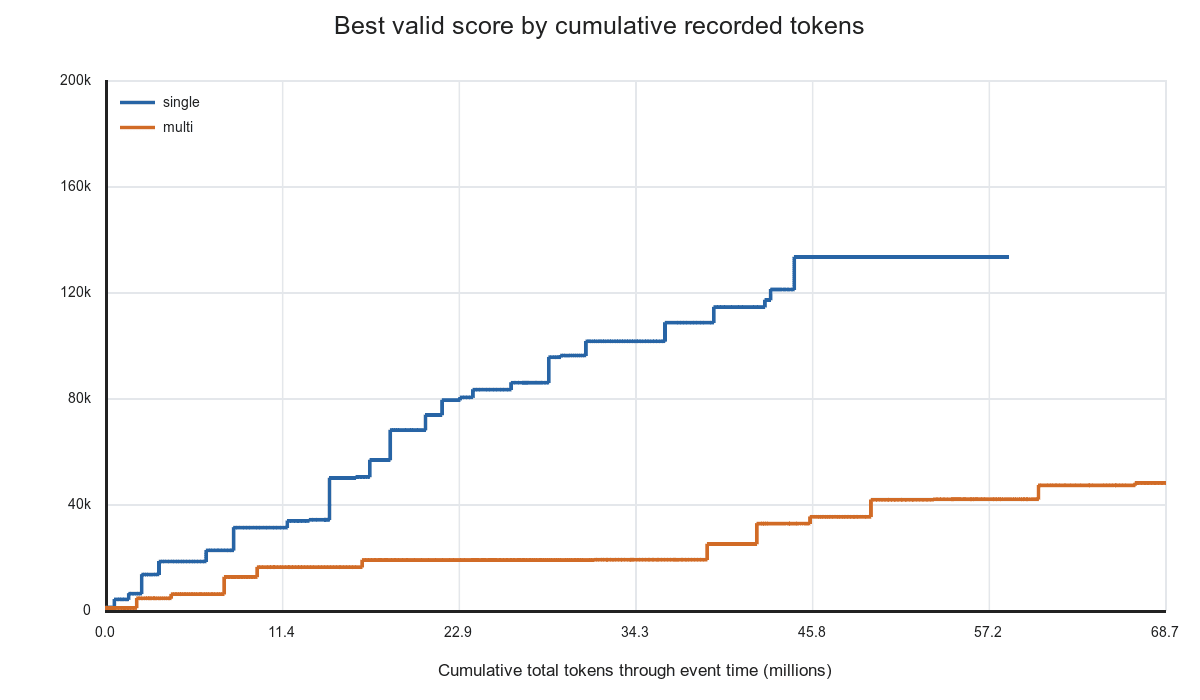 累積記録tokenに対する最高合格スコア。Astra単体とAstra+Sol協調
| トークン内訳 | Astra単体 | Astra+Sol協調 |
|---|---|---|
| input(cached込み) | 58,281,036 | 68,271,152 |
| cached input | 56,694,016 | 65,778,304 |
| uncached input | 1,587,020 | 2,492,848 |
| output(reasoning込み) | 220,579 | 386,886 |
| 合計 | 58,501,615 | 68,658,038 |
子へ渡すプロンプトは中央値4,580 bytes、各子スレッドの最大入力トークン中央値は32,587とコンパクトに保てていました。それでも、協調側の親Astraだけで62,367,072トークン(単体側の総量以上)を消費しています。子に実装を委譲しても、親が差分レビュー・ビルド確認・例外処理を一手に引き受けると、親の判断ループがボトルネックになり、結果として3時間あたりのベンチマーク試行回数(47回 vs 21回)が減ってしまいます。
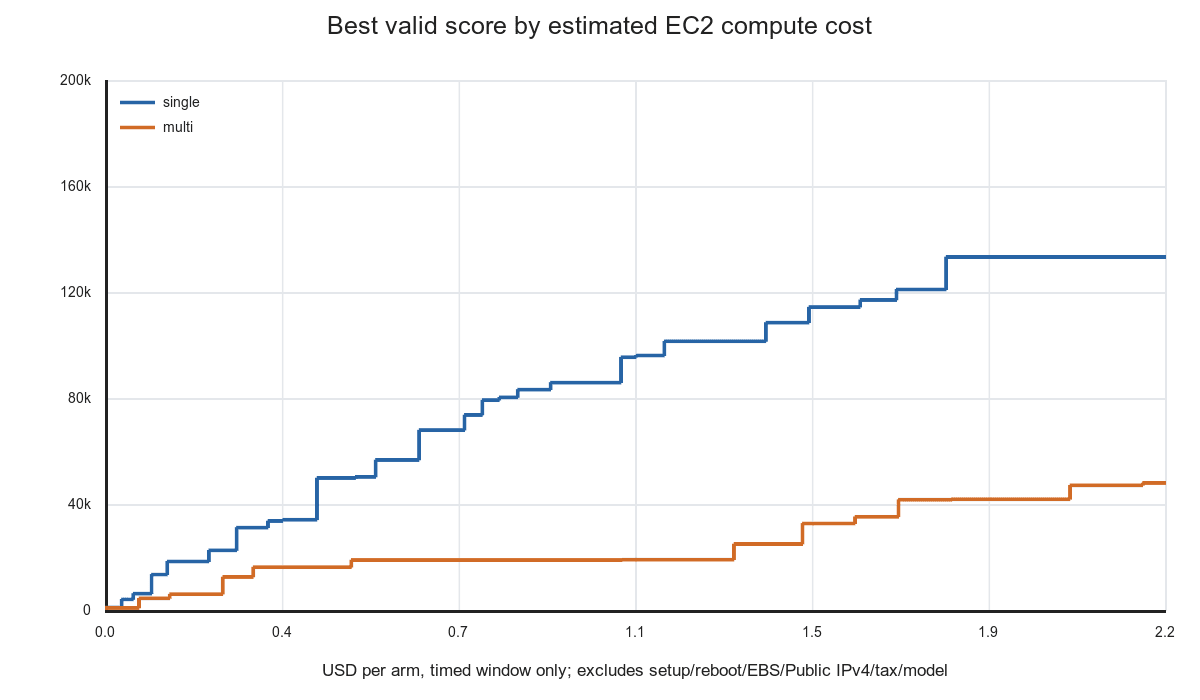 EC2の計算料金推計とスコアの推移
なお、3時間のEC2インスタンス計算料金は各群 $2.247(合計 $4.494、準備〜撤収込みで約 $5.05)でした。実験終了後、8台のEC2と関連リソースはすべて破棄(destroy)しています。
次の改善アクション
今回のログとコード比較から、次の順序でハーネスと最適化戦略を改善します。
- coordinator / executorのエラーハンドリング修正:準備失敗時のmanifest欠損ガード、turn番号付きGit ref、再起動後のDB待機リトライを修正し、タスクが途中で詰まらないようにする。
- 親エージェントのレビュー・ビルド判定の自動化:子ワーカーからの返却を「候補commit・差分・ビルド結果」に定型化し、機械的なビルド・テスト確認を親LLMのコンテキスト外で処理する。
- 1乗車あたりのDB書き込み回数の可視化:単発クエリのレイテンシだけでなく、1ライド完了あたりのINSERT/UPDATE回数とトランザクション数を集計して削減対象を選ぶ。
- 環境条件を揃えた再比較:インスタンス世代、MySQL永続化設定、3台への役割配分を揃えた状態で、単体と協調の試行回数・スコア推移を再計測する。
公開データ
集計データとスコア推移は以下のファイルで公開しています。